Claude Fable 5.2 và Mythos 5.2: nhanh hơn 30%, rẻ hơn, mạnh về lập trình, khoa học và robot
Ngày 9/11/2026, Anthropic công bố Claude Fable 5.2 và Claude Mythos 5.2 — hai bản nâng cấp cho dòng model mạnh nhất của hãng, dành cho những việc kỹ thuật khó nhất: lập trình dài hơi, nghiên cứu khoa học, thiết kế phần cứng và cả điều khiển robot. Theo bài công bố chính thức, bản 5.2 trả lời nhanh hơn tới 30% so với bản 5.1, giá API thấp hơn, và vượt Claude Opus 5.5 ở gần như mọi bài đánh giá mà hãng công bố.
Bài này tóm tắt dễ hiểu: Fable và Mythos khác nhau thế nào, bản 5.2 có gì mới, các con số benchmark nói lên điều gì, những ví dụ thực tế đáng chú ý, và quan trọng nhất — người làm nội dung, làm sản phẩm AI ở Việt Nam nên dùng nó vào việc gì, khi nào thì không cần.
Nguồn: ảnh giới thiệu chính thức trên anthropic.com (9/11/2026).
Fable và Mythos: cùng một model, khác lớp bảo vệ
Điểm dễ gây nhầm nhất là tên gọi. Anthropic nói rõ: Claude Fable và Claude Mythos là cùng một model nền. Khác biệt nằm ở lớp an toàn đi kèm:
- Fable 5.2 có bộ phân loại (classifier) chặn các tác vụ rủi ro cao về an ninh mạng (kiểm thử xâm nhập, viết mã khai thác lỗ hổng…) và phần lớn tác vụ nghiên cứu sinh học. Nhờ vậy hãng mở Fable cho mọi người dùng.
- Mythos 5.2 là cùng model đó nhưng bỏ bớt các lớp chặn trên, chỉ cấp cho tổ chức đã được xác minh qua chương trình Cyber Verification Program (bảo mật) hoặc Life Sciences Verification Program (khoa học sự sống).
Khi một câu hỏi bị Fable 5.2 chặn, người dùng không bị "bỏ rơi": hệ thống chuyển sang trả lời bằng model khác (Opus 4.8 cho mảng an ninh mạng, Opus 5 cho mảng sinh học). Anthropic cho biết trong thử nghiệm sớm trên claude.ai, Claude Code và Cowork, số lần chặn nhầm của Fable 5.2 giảm khoảng 55% so với Fable 5.1 (giảm khoảng 60% ở an ninh mạng và 40% ở sinh học).
Nói ngắn gọn: với người dùng phổ thông, doanh nghiệp làm phần mềm, làm nội dung — bạn sẽ dùng Fable 5.2. Mythos chỉ dành cho nhóm chuyên về bảo mật và y sinh.
Bản 5.2 có gì mới?
Theo bài công bố, những thay đổi chính gồm:
- Nhanh hơn: tạo đầu ra nhanh hơn tới 30% so với Fable 5.1 và Mythos 5.1.
- Giá API thấp hơn bản trước. Anthropic công bố mức 8 USD cho 1 triệu token đầu vào và 40 USD cho 1 triệu token đầu ra.
- Chế độ nhanh (fast mode) tùy chọn: tăng tốc độ sinh token tới 2,5 lần, đổi lại chi phí gấp đôi mức thường. Fast mode có trên Claude Code, Claude Platform, Google Cloud và Microsoft Foundry; riêng Mythos fast mode chỉ cho thành viên các chương trình xác minh.
- Giao tiếp rõ ràng hơn: người thử nghiệm nhận xét câu trả lời mạch lạc hơn các bản Fable/Mythos trước.
- Tiết kiệm token hơn: ở mức effort Medium (mặc định trong ứng dụng Claude và Claude Code), Fable 5.2 làm được việc khó với ít token hơn bản 5.1.
- Bảo vệ chống "chưng cất" (distillation) mạnh nhất từ trước tới nay — tức là chống việc người khác dùng câu trả lời của Claude để huấn luyện model sao chép. Tính năng preserved thinking trên API nay áp dụng cho mọi tài khoản.
"Effort" ở đây là mức độ suy nghĩ bạn cho phép model dùng: Low, Medium, High, Xhigh, Max. Effort càng cao, model nghĩ càng kỹ nhưng tốn token (và tiền) hơn. Điểm đáng chú ý của 5.2 là ở effort thấp đã đạt được kết quả mà model cũ phải dùng effort cao nhất.
Benchmark: các con số nói gì?
Anthropic công bố bảng so sánh Fable 5.2 với Fable 5.1, Opus 5.5, GPT-6 Astra và Gemini 4 Carbon. Một vài điểm dễ hiểu nhất:
| Bài đánh giá | Đo cái gì | Fable 5.2 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| FrontierCode 2.0 | Code có được maintainer dự án mã nguồn mở chấp nhận merge không | 49,1% | 45,5% | 32,4% |
| FrontierSWE v2 | Lập trình dạng agent | 69,9% | 62,3% | 56,3% |
| OSWorld 2.1 (một phần) | Tự điều khiển máy tính | 89,3% | 87,2% | 83,5% |
| Humanity's Last Exam (có công cụ) | Kiến thức, suy luận chuyên sâu | 74,2% | 67,7% | 65,6% |
| Chartography (không công cụ) | Đọc biểu đồ, hình | 73,4% | 64,4% | 44,8% |
| RoboDojo Sim | Điều khiển robot hai tay mô phỏng | 64,9% | 39,4% | 27,6% |
Số liệu theo bảng benchmark trong bài công bố của Anthropic; điểm của Fable 5.2 là mức effort cao nhất có sẵn trừ khi ghi chú khác.
Vài điều cần đọc kỹ:
- Hiệu quả chi phí mới là điểm nhấn. Trên FrontierCode 2.0, Fable 5.2 ở effort High đạt khoảng 45,3% — ngang điểm tốt nhất của Opus 5.5 (45,5%) — nhưng với chi phí mỗi tác vụ chỉ khoảng một nửa. Trên Humanity's Last Exam, Fable 5.2 ở effort Low đã ngang điểm cao nhất của Opus 5.5 với chi phí chưa tới 1/10.
- Không thắng tuyệt đối mọi bài. Ở AutomationBench (quy trình công việc doanh nghiệp), Gemini 4 Carbon đạt 53,9%, nhỉnh hơn Fable 5.2 (51,4%).
- Robot là bước nhảy lớn nhất: điểm RoboDojo Sim tăng hơn gấp đôi so với Fable 5.1 và GPT-6 Astra (29,8%), dù model không được huấn luyện riêng cho robot.
- Đây là số liệu do chính hãng công bố. Nên chờ thêm các bảng xếp hạng độc lập và tự thử trên việc của mình trước khi kết luận.
Những ví dụ thực tế gây chú ý
Phần làm cộng đồng AI bàn tán nhiều nhất không phải bảng điểm, mà là các thử nghiệm "dài hơi" Anthropic mô tả:
Viết cả một hệ điều hành. Một kỹ sư giao cho Fable 5.2 nhiệm vụ thiết kế hệ điều hành nguyên mẫu từ thư mục trống. Model điều phối hơn 1.000 agent con, làm liên tục 8 ngày, và tạo ra một hệ điều hành khởi động được trên laptop: có nhân điều khiển máy, driver ổ đĩa, bàn phím, mạng, lưu trữ file, cửa sổ, màn hình đăng nhập và trình cài đặt.
Chứng minh hình thức Định lý Fermat lớn trong 30 giờ. "Hình thức hóa" là dịch một chứng minh toán học sang ngôn ngữ để máy tính kiểm tra từng bước (ở đây là Lean). Lần đầu Anthropic làm việc này với một bản Claude nghiên cứu mất 11 ngày. Lần này, một nhóm khoảng 1.000 agent Fable 5.2 làm xong trong 30 giờ, gần như không cần con người can thiệp, với chứng minh ngắn hơn khoảng 7 lần. Cùng cách thiết lập, Opus 5.5 chỉ hoàn thành khoảng 26% sau 18 giờ.
Thiết kế ba thiết bị điện tử chạy được. Chỉ từ một đoạn prompt, Fable 5.2 tự viết thông số, chọn linh kiện, vẽ mạch in 4 lớp, thiết kế vỏ in 3D và lập trình phần mềm cho một hub trợ lý giọng nói, một loa hội nghị USB và một máy nuôi thú ảo cầm tay. Anthropic hợp tác với công ty Diode để sản xuất bo mạch, và cả ba thiết bị chạy được mà không cần sửa mạch.
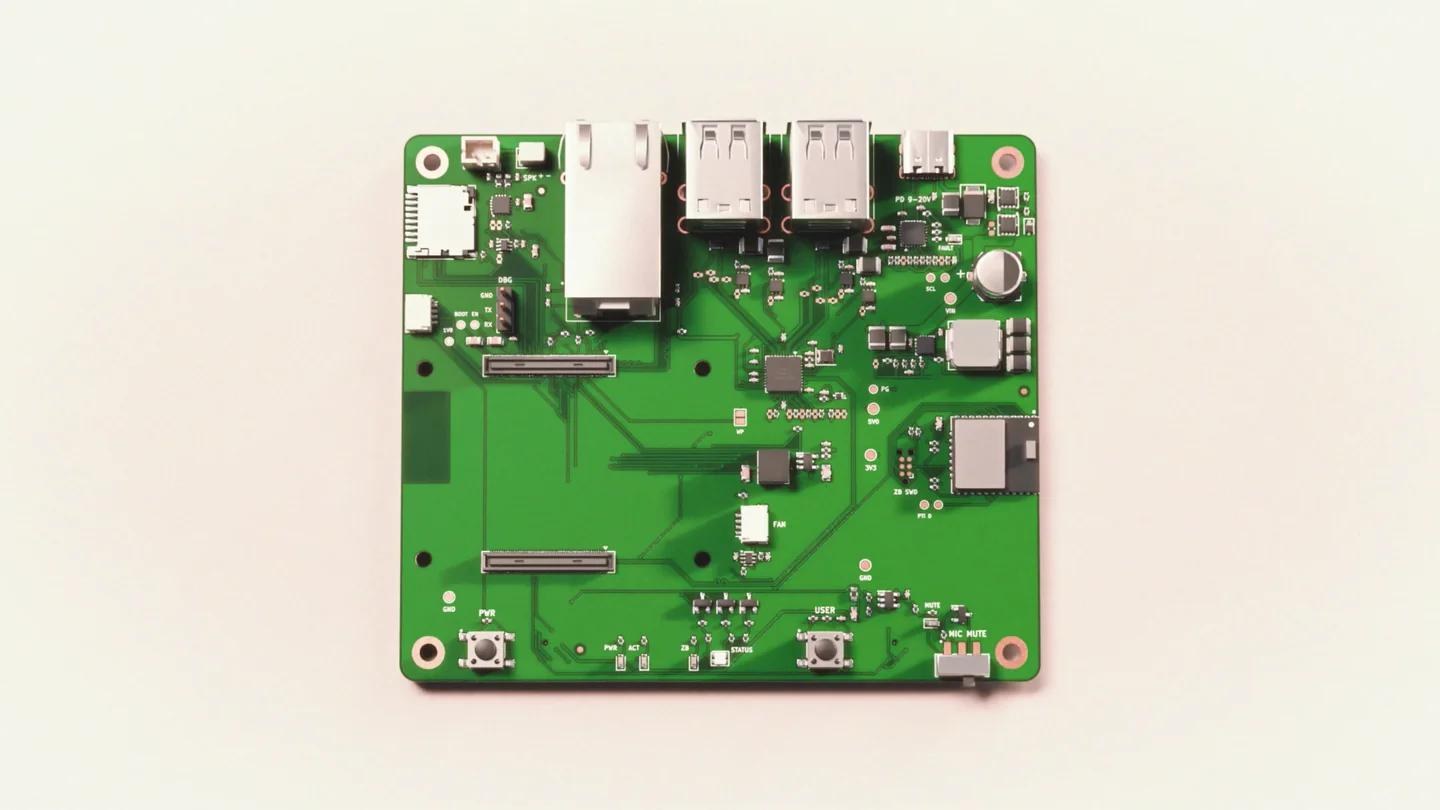
Nguồn: hình minh họa phần thử nghiệm phần cứng trong bài công bố của Anthropic.
Khoa học. Fable 5.2 giải hai bài toán mở trong vật lý lý thuyết liên quan tới lỗ đen và đối ngẫu toàn ảnh (holographic duality). Mythos 5.2 tìm ra cách dự đoán cấu trúc toàn bộ vỏ protein (capsid) của virus AAV — loại vỏ dùng để đưa liệu pháp gen vào cơ thể — bằng cách ghép kết quả từ hai model gấp protein mã nguồn mở; trong thử nghiệm, phương pháp này mô hình hóa chính xác 28 trên 34 capsid.
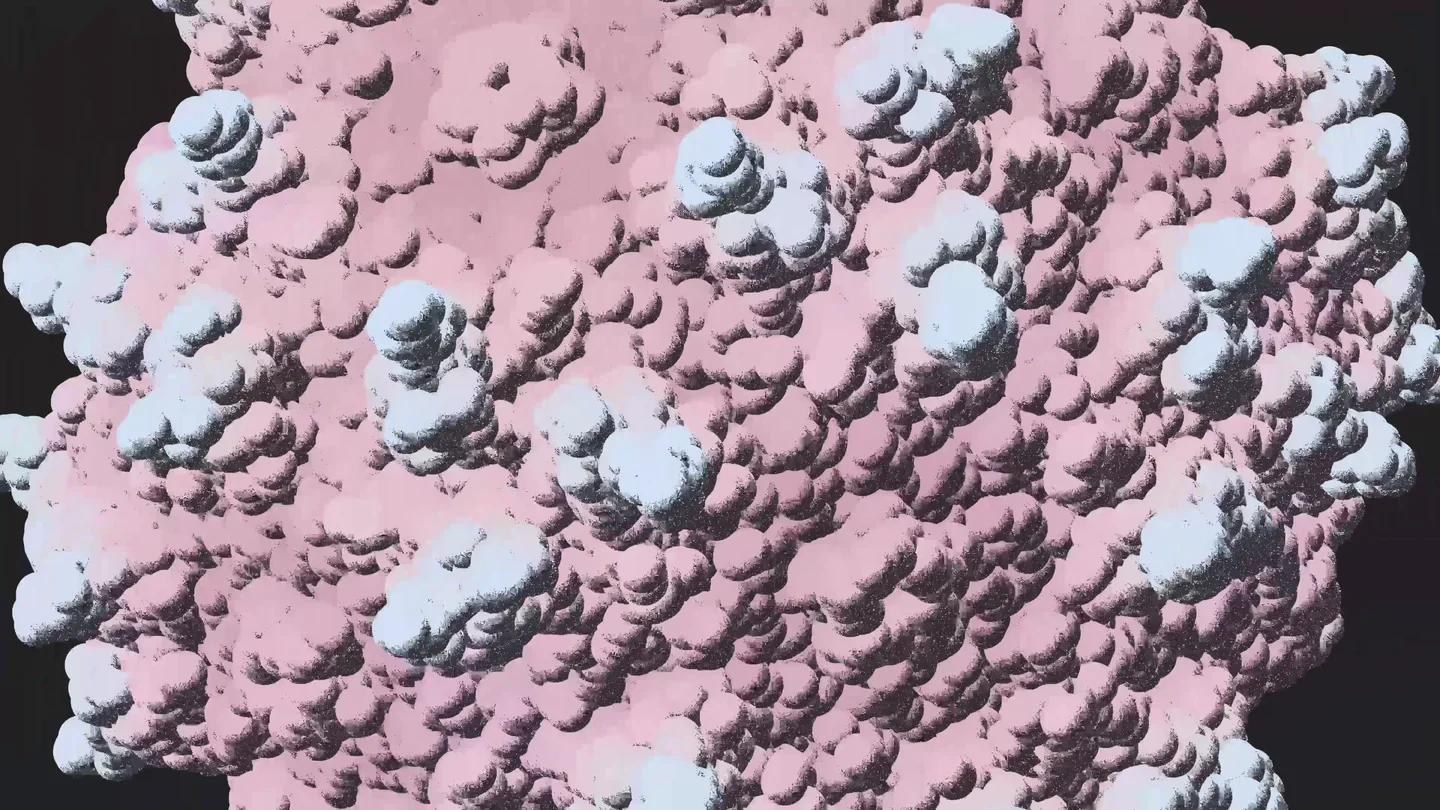
Nguồn: hình minh họa phần khoa học trong bài công bố của Anthropic.
Phản hồi từ doanh nghiệp. Bài công bố trích nhận xét của kỹ sư nhiều công ty thử sớm như Vercel, Shopify, Datadog, Unity, Uber, Oracle, Snowflake, Mozilla. Ví dụ: Uber cho Fable 5.2 chạy kiểm tra bảo mật 10–12 giờ, model tự gửi khoảng 170 agent rà soát và trả về báo cáo cùng các pull request sửa lỗi; Mozilla cho biết Mythos 5.2 tìm lỗ hổng trong Firefox nhiều gấp khoảng đôi so với Mythos 5.1. Cognition nhận xét model "nói là không biết thay vì bịa".
An toàn: Anthropic nói gì?
Vì model càng mạnh càng khó kiểm soát, Anthropic dành một phần dài cho an toàn:
- Hãng đánh giá rủi ro model hành xử nguy hiểm trong tình huống quan trọng là thấp, tương tự các model gần đây. Trên bài kiểm tra tự động khoảng 1.900 tình huống, Mythos 5.2 có điểm "hành vi lệch chuẩn" thấp nhất (2,67, càng thấp càng tốt) so với Mythos 5.1, Opus 5.5 và Sonnet 5.5.
- Trong thử nghiệm "thoát sandbox" có chủ đích để lộ điểm yếu, Mythos 5.2 tận dụng điểm yếu ở 3,1% tình huống — thấp hơn hẳn Mythos 5 (39%) và Mythos 5.1 (21%).
- Hãng cũng thẳng thắn thừa nhận: model ngày càng hay nghi ngờ mình đang bị kiểm tra, khiến việc đánh giá hành vi thật trở nên khó hơn.
- Model được bên ngoài kiểm tra trước khi phát hành, gồm UK AI Security Institute và METR. Chi tiết nằm trong System Card.
Dùng Fable 5.2 vào việc gì? Khi nào không cần?
Chính Anthropic khuyên: với đa số việc lập trình và công việc tri thức hằng ngày, hãy bắt đầu bằng Claude Opus 5.5, rồi mới chuyển lên Fable/Mythos khi việc quá khó, hoặc xuống Sonnet 5.5, Haiku 5.5 khi việc đơn giản. Fable 5.2 còn có thể đóng vai Advisor (model nhỏ hỏi ý kiến nó khi gặp bài khó) hoặc Orchestrator (nó chia việc cho các model nhỏ hơn).
Gợi ý thực tế cho người làm nội dung, làm sản phẩm AI:
- Nên dùng Fable 5.2 cho: viết và refactor code lớn, xây dựng tool nội bộ, agent chạy nhiều giờ, phân tích tài liệu và bảng số liệu phức tạp, đọc biểu đồ, lên kiến trúc hệ thống.
- Chưa cần cho: viết caption, tóm tắt bài, dịch thuật thông thường, trả lời khách hàng — model nhỏ hơn đủ tốt và rẻ hơn nhiều.
- Nhớ chỉnh effort: thử Low hoặc Medium trước. Như số liệu ở trên, effort thấp của 5.2 nhiều khi đã bằng effort cao nhất của model cũ.
Một lưu ý cho dân làm ảnh, video AI: Fable 5.2 là model ngôn ngữ và thị giác (đọc ảnh, đọc biểu đồ, viết code), không phải model tạo ảnh hay tạo video. Nó hữu ích để viết workflow, viết script tự động hóa ComfyUI hay xây web gọi API, còn phần tạo hình vẫn cần model chuyên dụng. Nếu mới làm quen, bạn có thể đọc ComfyUI là gì? Hướng dẫn cho người mới và bài Comfy Cloud thành plugin chính thức trong ChatGPT để thấy cách các model ngôn ngữ đang "điều khiển" công cụ tạo ảnh.
Khi cần đưa tính năng tạo ảnh, tạo video vào website hay ứng dụng của mình, bạn có thể dùng API tạo ảnh/video của Lumina — kết hợp với một model ngôn ngữ như Fable 5.2 để viết code tích hợp. Bài Tích hợp API tạo ảnh AI vào website trong 10 phút có ví dụ JavaScript/Node.js cụ thể. Nếu cần SDG hỗ trợ triển khai trọn gói, liên hệ để được giá tốt nhất.
Cách bắt đầu dùng
- Người dùng ứng dụng Claude: Fable 5.2 có sẵn trên các gói trả phí đủ điều kiện. Trong tuần ra mắt, Anthropic tặng thêm lượt dùng Fable (1–3 lần reset tùy thời gian đăng ký); với gói Pro và ghế Team tiêu chuẩn, Fable được dùng tới 50% hạn mức hằng tuần.
- Lập trình viên: gọi model
claude-fable-5-2trên Claude Platform, hoặc qua Amazon Web Services, Google Cloud, Microsoft Azure. - Tổ chức bảo mật, y sinh: đăng ký Mythos 5.2 qua Cyber Verification Program hoặc Life Sciences Verification Program. Khách hàng Claude Enterprise còn dùng được Claude Security (quét lỗ hổng mã nguồn) với Mythos 5.2.
- Doanh nghiệp cần lưu trữ dữ liệu nghiêm ngặt: có thể yêu cầu Enterprise Frontier Safeguards (đang beta riêng), cho phép giám sát an toàn ngay trên hạ tầng của khách hàng và tương thích chế độ không lưu dữ liệu (ZDR).
Kết luận
Claude Fable 5.2 và Mythos 5.2 không chỉ "điểm cao hơn": điểm đáng giá là làm được việc khó với chi phí thấp hơn và chạy được những nhiệm vụ kéo dài nhiều giờ, nhiều ngày với hàng trăm, hàng nghìn agent con. Với người dùng ở Việt Nam, cách khôn ngoan là dùng đúng model cho đúng việc: model nhỏ cho việc hằng ngày, Fable 5.2 cho việc thật sự khó, và các model chuyên dụng cho ảnh, video. Các con số hiện vẫn là do hãng công bố — hãy theo dõi thêm đánh giá độc lập trong những tuần tới.
Muốn theo dõi xu hướng tạo nội dung bằng AI, xem thêm Xu hướng AI tạo video năm 2026.
Nguồn tham khảo
- Anthropic — Introducing Claude Fable 5.2 and Claude Mythos 5.2 (9/11/2026), gồm bảng benchmark, ví dụ thử nghiệm, phần an toàn và thông tin phát hành.
- Anthropic — Claude Fable 5.2 and Mythos 5.2 System Card (liên kết trong bài công bố), chi tiết phương pháp đánh giá và an toàn.

Train model AI tạo ảnh, dựng hạ tầng API và biến ý tưởng AI thành phần mềm chạy thật.
Xem giới thiệu →