llama.cpp 1.0 chính thức ra mắt: API ổn định, KV cache FP8 và Web UI mới cho AI chạy cục bộ
Ngày 13/11/2026, nhóm ggml-org chính thức phát hành llama.cpp v1.0.0, đi kèm thư viện nền ggml v1.0.0. Sau khoảng 3,5 năm phát triển với hàng nghìn bản build "nightly", đây là lần đầu tiên dự án chạy AI cục bộ phổ biến bậc nhất thế giới gắn nhãn 1.0. Bài giới thiệu trên blog Hugging Face có tiêu đề rất rõ ý: "A stronger foundation for the local AI ecosystem" – một nền móng vững chắc hơn cho hệ sinh thái AI chạy trên máy cá nhân.
Nghe "1.0" nhiều người sẽ nghĩ đến một bước nhảy lớn về tốc độ. Thực tế thú vị hơn: điểm quan trọng nhất của bản này là một lời cam kết về sự ổn định, cộng thêm một loạt tính năng đáng giá như KV cache FP8, bộ nhớ đệm chuyên gia cho model MoE, endpoint chuyển văn bản thành giọng nói tương thích OpenAI, siết chặt bảo mật cho llama-server và giao diện web được thiết kế lại. Trong bài này, Sydigi tóm tắt dễ hiểu những gì đã thay đổi, ai nên nâng cấp và cách bắt đầu nhanh.
 Nguồn: ảnh banner trong trang phát hành llama.cpp v1.0.0 trên GitHub và blog Hugging Face, 13/11/2026.
llama.cpp là gì? (dành cho người mới)
llama.cpp là một chương trình mã nguồn mở viết bằng C/C++ dùng để chạy model ngôn ngữ lớn (LLM) và model đa phương thức (đọc ảnh, nghe âm thanh) ngay trên máy của bạn, không cần gửi dữ liệu lên dịch vụ đám mây. Theo README chính thức, mục tiêu của dự án là chạy model "với thiết lập tối thiểu và hiệu năng hàng đầu trên nhiều loại phần cứng – cả cục bộ lẫn trên cloud".
Một số đặc điểm làm nên tên tuổi của llama.cpp:
- Không phụ thuộc thư viện ngoài, viết thuần C/C++, nên dễ đóng gói vào ứng dụng khác.
- Lượng tử hóa (quantization) từ 1,5-bit đến 8-bit giúp model nhỏ hơn nhiều so với bản gốc, chạy được trên laptop, máy Mac hay PC chơi game.
- Chạy lai CPU + GPU: nếu model lớn hơn VRAM, một phần vẫn có thể chạy trên CPU.
- Hỗ trợ rất nhiều "backend" phần cứng: CUDA (NVIDIA), HIP (AMD), Metal (Apple Silicon), Vulkan, SYCL (Intel), OpenCL (GPU Adreno), Hexagon (Snapdragon), WebGPU…
- Định dạng model GGUF – định dạng bạn thường thấy trong tên các repo model trên Hugging Face như
...-GGUF. - Có sẵn máy chủ API tương thích OpenAI (
llama-server), nên các ứng dụng viết cho API OpenAI có thể trỏ sang model chạy trên máy bạn.
Theo blog Hugging Face, llama.cpp hiện hỗ trợ hơn 150 biến thể kiến trúc model cùng các phương pháp speculative decoding (giải mã suy đoán) phổ biến. Thư viện tính toán bên dưới là ggml, được thiết kế để chạy trên "gần như mọi phần cứng đang tồn tại".
Có thể hình dung llama.cpp với LLM giống ComfyUI với tạo ảnh: một "động cơ" chạy model cục bộ mà nhiều công cụ khác xây bên trên. (Chưa biết ComfyUI? Xem bài ComfyUI là gì? Hướng dẫn cho người mới bắt đầu.)
Vì sao con số 1.0 lại quan trọng?
Trước đây, phiên bản phát hành gần nhất của llama.cpp vẫn mang số v0.9.0, còn đa số người dùng tải các bản build đánh số kiểu b12xxx được tạo liên tục từ nhánh chính. Cách làm này giúp dự án tiến rất nhanh, nhưng lại gây khó cho những ai xây ứng dụng phía trên llama.cpp: chỉ một thay đổi nhỏ trong API cũng có thể làm hỏng ứng dụng của họ mà không có dấu hiệu báo trước.
Blog chính thức giải thích: sau 3,5 năm, rất nhiều ứng dụng đã phụ thuộc vào llama.cpp, và "mỗi tích hợp mới nghĩa là thêm nhiều nhà phát triển phụ thuộc vào giao diện thư viện của chúng tôi, vì vậy một API linh hoạt nhưng ổn định là điều tối quan trọng". Từ bản 1.0, cả llama.cpp và ggml áp dụng semantic versioning (đánh số phiên bản theo ngữ nghĩa) với ba quy tắc:
| Loại thay đổi | Tăng số |
|---|---|
Thay đổi phá vỡ tương thích API C công khai (thư mục include) |
MAJOR (ví dụ 1.x → 2.0) |
| Thêm tính năng tương thích ngược, cập nhật backend, hỗ trợ model mới, thêm API | MINOR (ví dụ 1.0 → 1.1) |
| Sửa lỗi, không đổi API | PATCH (ví dụ 1.0.0 → 1.0.1) |
Nói đơn giản: chừng nào số đầu tiên chưa đổi, ứng dụng viết cho llama.cpp 1.x sẽ không bị "gãy" vì thay đổi API công khai. Cần lưu ý cam kết này áp dụng cho API C công khai, chứ không bao trùm mọi tham số dòng lệnh của các công cụ đi kèm.
Theo tài liệu về quy trình phát hành của ggml-org, từ nay có hai "kênh" rõ ràng:
- Bản nightly (thẻ
b[số]): build liên tục từ nhánhmaster, có thể chứa bản sao ggml nội bộ khác bản ggml chính thức. - Bản phát hành chính thức (thẻ
vX.Y.Z): chỉ được tạo khi bản ggml bên trong giống hệt bản ggml đã phát hành, đảm bảo ai build từ thẻ phát hành và liên kết với ggml cài sẵn trong hệ thống sẽ tương thích.
Đây là tin tốt cho các kênh đóng gói như Homebrew, Debian, conda-forge, Winget hay MacPorts.
Cái giá của việc "dọn nhà"
Để có nền móng sạch sẽ, bản 1.0 chấp nhận một số thay đổi phá vỡ tương thích (theo release notes):
- Xóa 35 hàm đã bị đánh dấu lỗi thời khỏi
llama.h, cùng hàmllama_set_warmup. - Bỏ tham số
defrag_tholdvà cờ dòng lệnh--defrag-thold. - Đổi tên
llama_set_embd_state_srcthànhllama_set_ctx_state_src. - Header
clip.hbị loại bỏ, phần xử lý đa phương thức được gom vào thư việnmtmd. - Phía ggml bỏ API công khai lỗi thời và các phép toán
DIAG_MASKcũ.
Nếu bạn có script cũ truyền cờ --defrag-thold, hay code tự viết gọi các hàm đã bị xóa, hãy sửa trước khi nâng cấp.
Những tính năng mới đáng chú ý
1. KV cache FP8 – tiết kiệm bộ nhớ khi chạy ngữ cảnh dài
Khi model "đọc" đoạn hội thoại, nó lưu lại các giá trị trung gian gọi là KV cache. Ngữ cảnh càng dài, KV cache càng phình to và nhiều khi chiếm bộ nhớ không kém bản thân model. llama.cpp 1.0 thêm hỗ trợ KV cache dạng FP8 (chuẩn OCP FP8) qua cờ -ctk f8_e4m3 -ctv f8_e4m3, có thể dùng kèm hệ số tỉ lệ tĩnh theo từng tensor nếu model cung cấp.
Về nguyên lý, mỗi giá trị FP8 chiếm 1 byte thay vì 2 byte như F16, nên phần bộ nhớ dành cho KV cache có thể giảm khoảng một nửa so với F16. Mức ảnh hưởng tới chất lượng câu trả lời tùy model, vì vậy bạn nên thử trên chính tác vụ của mình trước khi dùng lâu dài.
2. Bộ nhớ đệm chuyên gia cho model MoE
Các model MoE (Mixture of Experts) chia thành nhiều "chuyên gia", mỗi lần chỉ dùng một phần. Bản 1.0 thêm bộ nhớ đệm chuyên gia đặt ở RAM máy chủ cùng tham số cho phép tính một phần chuyên gia "trượt cache" ngay trên CPU (thay vì chờ chép sang GPU), kèm các chiến lược thay thế cache mới. Trong pull request gốc, tác giả còn bổ sung script scripts/moe-cache-tune.py để tự dò cấu hình phù hợp với máy của bạn (kích thước cache và tỉ lệ chia cho CPU).
Điều này đặc biệt hữu ích cho người có GPU tầm trung muốn chạy model MoE lớn hơn VRAM.
3. Model mới và đa phương thức
Release notes liệt kê các kiến trúc được hỗ trợ mới:
- Kimi-K3.1-Pro (biến thể của Kimi K3) và khả năng nhìn ảnh của Kimi-K3.1.
- Ripple-65B-Preview – kiến trúc dense 65B mới.
- xing4_0 – kiến trúc kết hợp MoE, MLA và MTP.
- drama-3 TTS của Fish Audio – model chuyển văn bản thành giọng nói.
- MageVL-Cowork (model thị giác) và hỗ trợ nhập âm thanh dạng streaming cho Gemma 4.
4. Server: thêm giọng nói, siết bảo mật
llama-server – thành phần nhiều người dùng để biến máy tính thành "API riêng" – có các thay đổi đáng chú ý:
- Thêm endpoint
/v1/audio/speechtương thích OpenAI, giúp ứng dụng đang gọi API giọng nói kiểu OpenAI có thể chuyển sang chạy cục bộ. - Bảo mật chặt hơn: sửa lỗi liên quan đến
--cors-origins, DNS rebinding và SSRF qua proxy CORS. Nếu bạn bật tools hoặc MCP trong khi server lắng nghe trên địa chỉ không phải localhost mà không đặt API key, server sẽ từ chối khởi động, trừ khi bạn chủ động thêm cờ--allow-unauthenticated-tools. Việc đọc URL ảnh/media trong mạng nội bộ cũng cần bật rõ ràng bằng--media-allow-private-urls. - Biến
HF_TOKENchỉ được gửi tới các máy chủ huggingface.co. - Lệnh gọi công cụ MCP được hủy khi client ngắt kết nối hoặc hết thời gian chờ.
Hơi bất tiện với cấu hình cũ, nhưng rất đáng giá nếu bạn mở server ra mạng LAN hoặc Internet.
5. Giao diện web làm mới
Web UI đi kèm server được thiết kế lại: gom cuộc trò chuyện thành nhóm có tên, thanh bên có thể thu gọn và sắp xếp, ô nhập liệu có xem trước Markdown trực tiếp, giao diện riêng cho điện thoại, hiển thị văn bản và ảnh thu nhỏ trang khi đính kèm PDF, cùng công cụ search_chats để tìm lại hội thoại cũ.
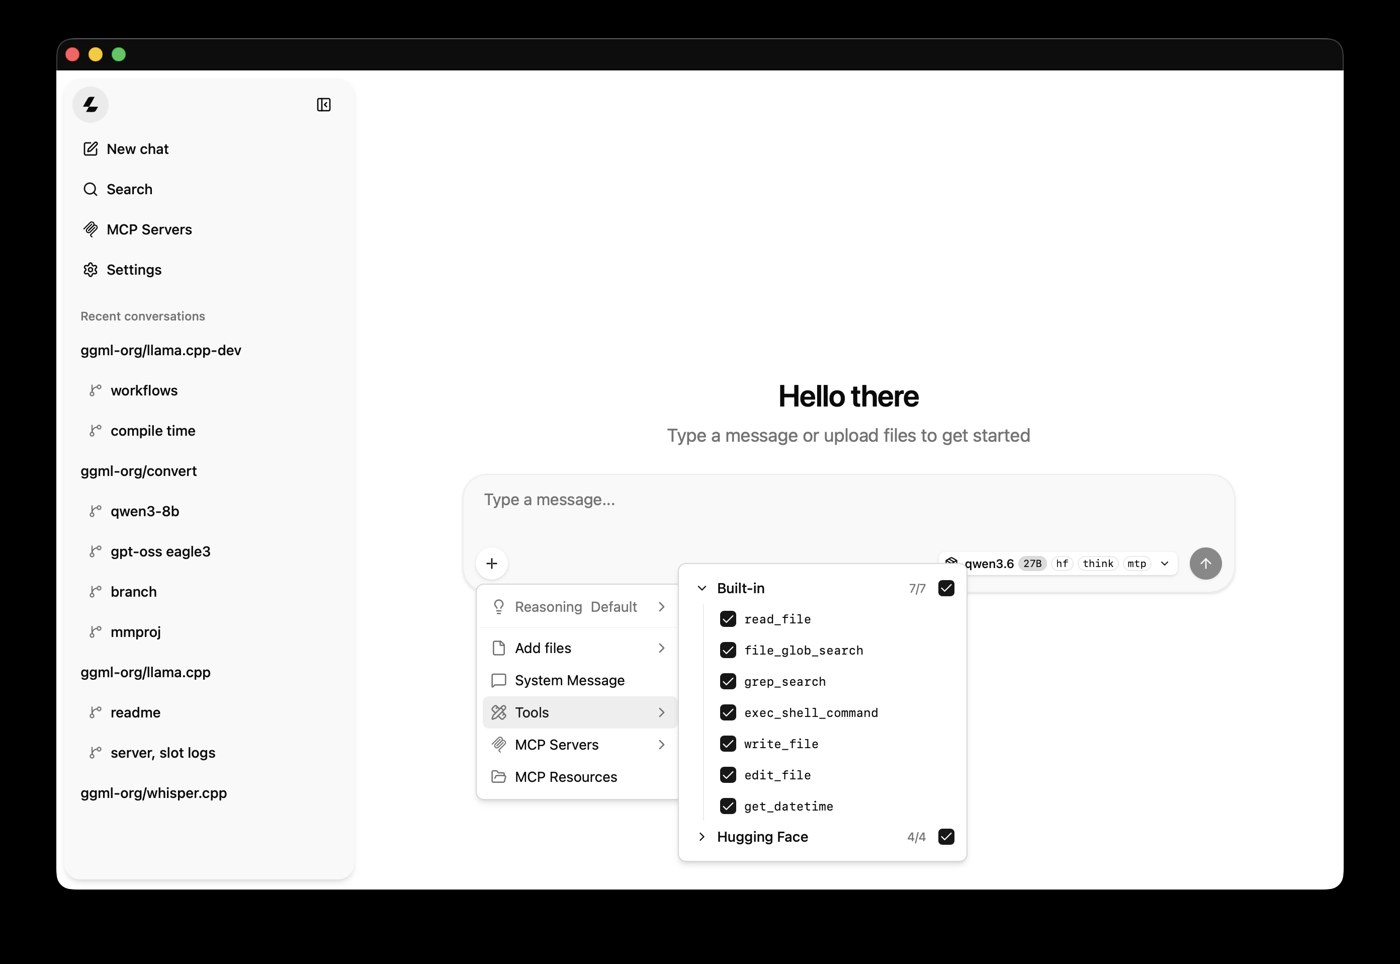 Nguồn: ảnh chụp giao diện web tích hợp chạy với
llama serve, trong README chính thức của llama.cpp trên GitHub.
6. ggml 1.0: tối ưu trên nhiều phần cứng
Thư viện ggml 1.0 bổ sung hỗ trợ FP8, tùy chỉnh YaRN (kỹ thuật kéo dài ngữ cảnh) và hàng loạt tối ưu hiệu năng: nhân ma trận lượng tử hóa và hợp nhất phép toán MoE trên CUDA/Metal, đường FlashAttention cho giai đoạn đọc prompt trên Vulkan, bộ lập lịch MoE trên SYCL, kernel mới cho WebGPU và mở rộng hỗ trợ cho Hexagon (Snapdragon).
Bắt đầu nhanh với llama.cpp 1.0
README hiện tại của dự án đưa ra cách cài đặt gọn nhất qua trang llama.app:
# macOS / Linux
curl -LsSf https://llama.app/install.sh | sh

# Windows (PowerShell)
irm https://llama.app/install.ps1 | iex
Mẹo an toàn: trước khi chạy một script cài đặt dạng "tải về rồi chạy ngay", bạn nên mở link ra đọc nội dung trước. Ngoài ra, bạn có thể tải bản build sẵn ở trang Releases trên GitHub, dùng Docker, Homebrew, Winget hoặc tự build từ mã nguồn.
Sau khi cài, chỉ cần một dòng lệnh để tải model từ Hugging Face và trò chuyện:
# Tải và chạy model trực tiếp từ Hugging Face
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF

# Mở server API tương thích OpenAI
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
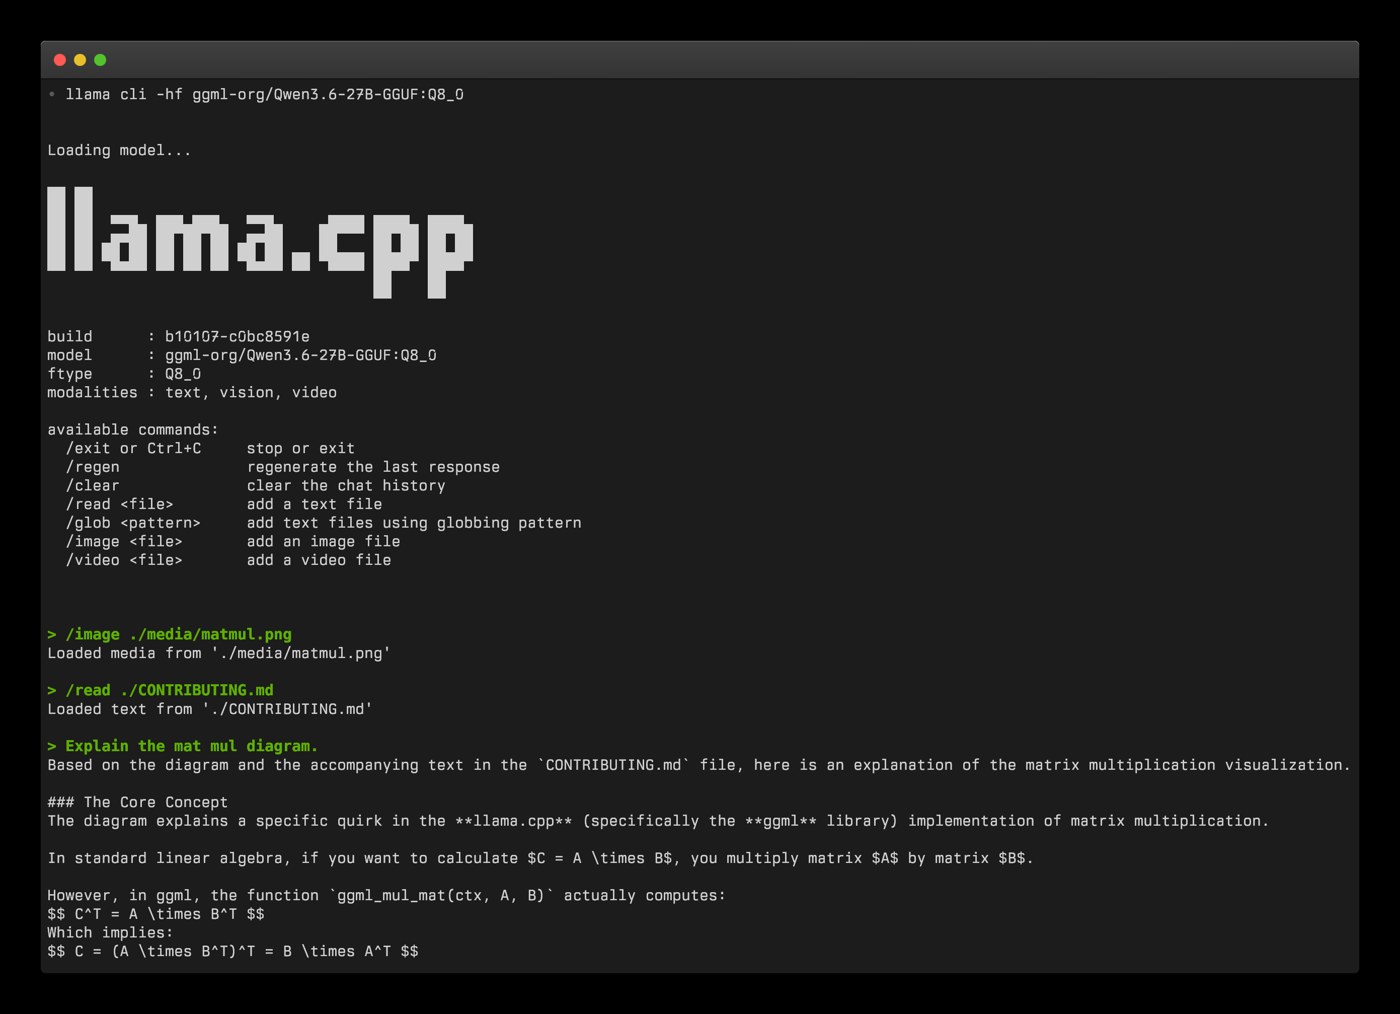 Nguồn: ảnh chụp phiên
llama cli với model thị giác, trong README chính thức của llama.cpp trên GitHub.
Khi server đã chạy, bạn có thể gọi nó như gọi API OpenAI (địa chỉ và cổng xem trong log khi khởi động, mặc định của llama-server là cổng 8080):
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Giải thích KV cache trong 3 câu"}]}'
Một vài lời khuyên thực tế:
- Bắt đầu với model nhỏ (vài trăm triệu đến vài tỉ tham số) để kiểm tra máy chạy ổn, rồi mới thử model lớn.
- Thiếu VRAM khi ngữ cảnh dài? Thử KV cache FP8 bằng
-ctk f8_e4m3 -ctv f8_e4m3, sau đó so sánh chất lượng câu trả lời với cấu hình mặc định. - Mở server ra mạng LAN? Luôn đặt API key. Bản 1.0 sẽ chặn trường hợp bật tools/MCP mà không có xác thực – đừng vội tắt cơ chế này bằng
--allow-unauthenticated-toolsnếu không thật sự hiểu rủi ro. - Cần sự ổn định cho sản phẩm? Hãy ghim theo thẻ phát hành
v1.x.ythay vì bản nightlyb[số].
Ai nên nâng cấp ngay?
- Nhà phát triển ứng dụng, binding, plugin dựa trên llama.cpp: nên chuyển sang dòng 1.x để hưởng cam kết API ổn định, nhưng cần rà lại code nếu đang dùng các hàm đã bị xóa.
- Người tự host server cho nhóm hoặc công ty nhỏ: nên nâng cấp vì các bản vá bảo mật (CORS, SSRF, DNS rebinding) và cơ chế bắt buộc xác thực khi mở tools.
- Người dùng cuối chỉ dùng qua ứng dụng khác: chờ ứng dụng đó cập nhật là đủ, không cần thao tác gì thêm.
Cũng cần nhìn nhận đúng mức: như nhiều bài phân tích độc lập đã chỉ ra, bản 1.0 chủ yếu đánh dấu sự trưởng thành của dự án chứ không hứa hẹn một cú nhảy vọt về tốc độ. Một chi tiết nhỏ khác: theo tài liệu quy trình phát hành của ggml-org, kênh cài đặt llama.app hiện vẫn phát bản nightly thay vì bản phát hành chính thức (nhóm phát triển ghi chú đây là việc có thể chuyển đổi sau).
llama.cpp và bức tranh AI chạy cục bộ năm 2026
Bản 1.0 ra mắt trong một tuần sôi động của AI mã nguồn mở, khi MiniMax H3-Image vừa mở trọng số (xem bài MiniMax H3-Image tạo ảnh 4K trong ComfyUI) và các model đóng như Gemini 4 Hydrogen tăng tốc cho agent. llama.cpp là "hạ tầng ngầm" của rất nhiều ứng dụng chat cục bộ và agent riêng tư.
Chạy cục bộ mang lại quyền riêng tư và chủ động chi phí khi đã có phần cứng, đổi lại bạn tự lo cài đặt và giới hạn của máy. Cách làm hợp lý cho nhiều đội nhóm là kết hợp: model cục bộ cho văn bản nhạy cảm, còn tạo ảnh, video chất lượng cao thì gọi qua API.
Nếu bạn đang xây website hoặc ứng dụng cần tạo ảnh, tạo video bằng AI qua API mà không muốn tự vận hành GPU, có thể tham khảo cổng API Lumina – gọi nhiều model tạo ảnh, video qua một đầu mối thống nhất. Hướng dẫn tích hợp mẫu có trong bài Tích hợp API tạo ảnh AI vào website. Về chi phí: liên hệ để được giá tốt nhất.
Tóm tắt
llama.cpp 1.0 là cột mốc về sự ổn định: API công khai được cam kết theo semantic versioning, đi kèm KV cache FP8, bộ nhớ đệm MoE, endpoint giọng nói, Web UI mới và bảo mật server chặt hơn.
Sydigi sẽ tiếp tục theo dõi các bản 1.x tiếp theo và cập nhật hướng dẫn chạy model cục bộ chi tiết hơn. Theo dõi chuyên mục Tin tức AI để không bỏ lỡ.
Nguồn tham khảo
- ggml-org trên GitHub: Release llama.cpp v1.0.0, 13/11/2026.
- Hugging Face Blog: llama.cpp v1.0.0: A stronger foundation for the local AI ecosystem, 13/11/2026.
- ggml-org trên GitHub: README của llama.cpp (hướng dẫn cài đặt, danh sách backend, ảnh chụp giao diện).
- ggml-org trên GitHub: Releases and versioning of ggml-org projects.
- ggml-org trên GitHub: ggml v1.0.0.
- Pull request: Add FP8 KV-cache support (#28392), llama_moe_cache: run missed experts on CPU (#30966), server: explicit opt-in tools via non-loopback addr (#32113).
- Piotr Sobolewski: llama.cpp 1.0: a stable API after 3.5 years of development.

Train model AI tạo ảnh, dựng hạ tầng API và biến ý tưởng AI thành phần mềm chạy thật.
Xem giới thiệu →