MiniMax H3-Image mở trọng số: tạo ảnh 4K dưới 10 giây, 16 ảnh tham chiếu và cách chạy trong ComfyUI
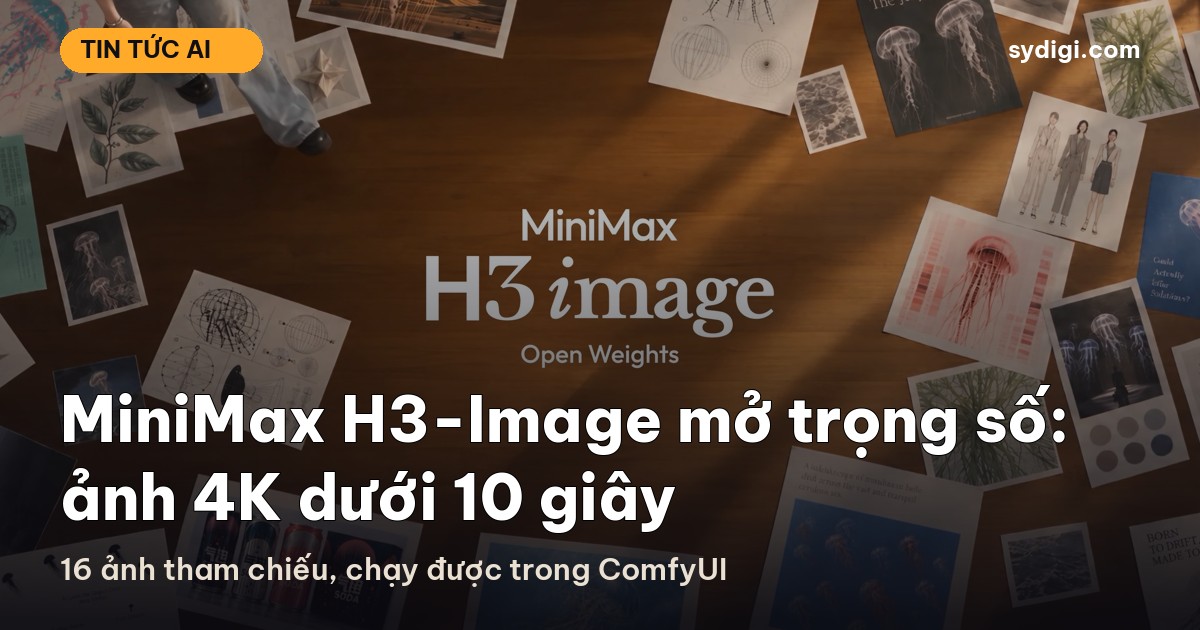
Ngày 11/11/2026, MiniMax công bố MiniMax H3-Image, một model tạo ảnh và chỉnh sửa ảnh xây trên nền H3, và phát hành luôn trọng số mở trên Hugging Face. Lời giới thiệu ngắn gọn của hãng: tạo được ảnh 4K (4096 × 4096) trong chưa tới 10 giây, chi tiết chân thực, bám prompt tốt và hiểu được tối đa 16 ảnh tham chiếu trong một lần tạo.
ComfyUI đã có sẵn hai template chính thức (tạo ảnh từ chữ và chỉnh sửa ảnh), còn trang Hugging Face của model ghi nhận hơn 140.000 lượt tải và hơn 700 lượt thích. Đây là một trong những bản phát hành được cộng đồng làm ảnh AI quan tâm nhiều nhất tuần này.
Bài viết tóm tắt H3-Image là gì, khác gì so với các model ảnh mở khác, cần phần cứng ra sao, cách chạy trong ComfyUI, giấy phép cần lưu ý điểm nào và người làm nội dung ở Việt Nam nên tận dụng thế nào. Số liệu lấy từ trang chính thức của MiniMax, Hugging Face và tài liệu ComfyUI, dẫn nguồn ở cuối bài.
Lưu ý: các con số về tốc độ và chất lượng là do MiniMax tự công bố, đo trên hạ tầng của họ. Tốc độ trên máy cá nhân của bạn sẽ khác, thường chậm hơn nhiều.
 Nguồn: ảnh giới thiệu chính thức trên MiniMaxAI/MiniMax-H3-Image (Hugging Face).
MiniMax H3-Image là gì?
Nếu bạn đã đọc bài Pika H3 Flex và P-H3-Image: hệ sinh thái MiniMax H3 bùng nổ trên sydigi.com, bạn sẽ biết MiniMax H3 vốn là model tạo video có âm thanh mà MiniMax mở trọng số từ đầu tháng 8/2026. Từ đó, nhiều nhóm bên ngoài đã "biến tấu" H3 thành model ảnh, tiêu biểu là P-H3-Image của Pruna AI.
H3-Image là lần đầu tiên chính MiniMax làm việc này. Theo thẻ model trên Hugging Face:
- Một checkpoint cho cả hai việc: vừa tạo ảnh từ văn bản (text-to-image), vừa chỉnh sửa một hoặc nhiều ảnh tham chiếu (image editing). Bạn không cần tải thêm model chỉnh sửa hay adapter riêng.
- Ảnh khoảng 16 megapixel ở mọi tỉ lệ khung hình, từ 4096 × 4096 (1:1) đến 6272 × 2688 (21:9), tạo trực tiếp mà không cần upscaler.
- Chỉ 6 bước lấy mẫu, không dùng classifier-free guidance (CFG). Nói dễ hiểu: model đã được "chưng cất" (distill) để ra ảnh nhanh với rất ít bước, và vì không có CFG nên cũng không có negative prompt.
- Phần lõi là diffusion transformer (DiT) 33,1 tỉ tham số, kiến trúc giống H3 nhưng bỏ nhánh âm thanh, và dùng nguyên bộ mã hoá văn bản (text encoder) Qwen3-VL của MiniMax-H3.
MiniMax cho biết không có một thay đổi đơn lẻ nào tạo nên khác biệt. Họ cải tiến toàn bộ quy trình hậu huấn luyện: dữ liệu, học tăng cường (reinforcement learning), giảm số bước lấy mẫu, mở rộng prompt và tối ưu triển khai. Tổng hợp lại, model đạt được cả ba thứ cùng lúc: tốc độ, chất lượng ảnh và khả năng bám prompt.
Ba điểm mạnh MiniMax nhấn mạnh
1. Ảnh 4K trong chưa tới 10 giây
Phần lớn model tạo ảnh phổ biến hiện nay cho ra ảnh 1–4 megapixel (khoảng 1K–2K). Ảnh 16 megapixel chi tiết hơn rất nhiều nhưng thường tốn tính toán gấp bội. MiniMax nói H3-Image tạo một ảnh 4K đầy đủ độ phân giải trong chưa tới 10 giây, nhanh tới 5 lần các lựa chọn phổ biến khác. Trên nền tảng API của hãng, chế độ Standard nhanh hơn 1,5–2 lần và chế độ Highspeed nhanh hơn 3–4 lần so với các dịch vụ tương đương (theo số liệu MiniMax công bố).
Với người làm nội dung, điều này có nghĩa là bạn có thể tạo thẳng ảnh đủ nét để in poster, banner khổ lớn hay cắt ra nhiều khung hình khác nhau, thay vì phải tạo ảnh nhỏ rồi chạy thêm bước phóng to.
2. Chi tiết chân thực, bớt "mùi AI"
Một điểm hay bị chê ở ảnh AI là bề mặt quá mịn, quá "sạch", nhìn là biết máy làm. MiniMax nói H3-Image cho chi tiết tự nhiên hơn, từ kết cấu vật liệu đến các chi tiết nhỏ, với mục tiêu thu hẹp khoảng cách giữa ảnh AI và thế giới thật. Bộ ảnh mẫu chính thức trải rộng từ ảnh chụp chân thực, ý tưởng bối cảnh, nhân vật và đạo cụ, đến tranh minh hoạ nhiều phong cách.
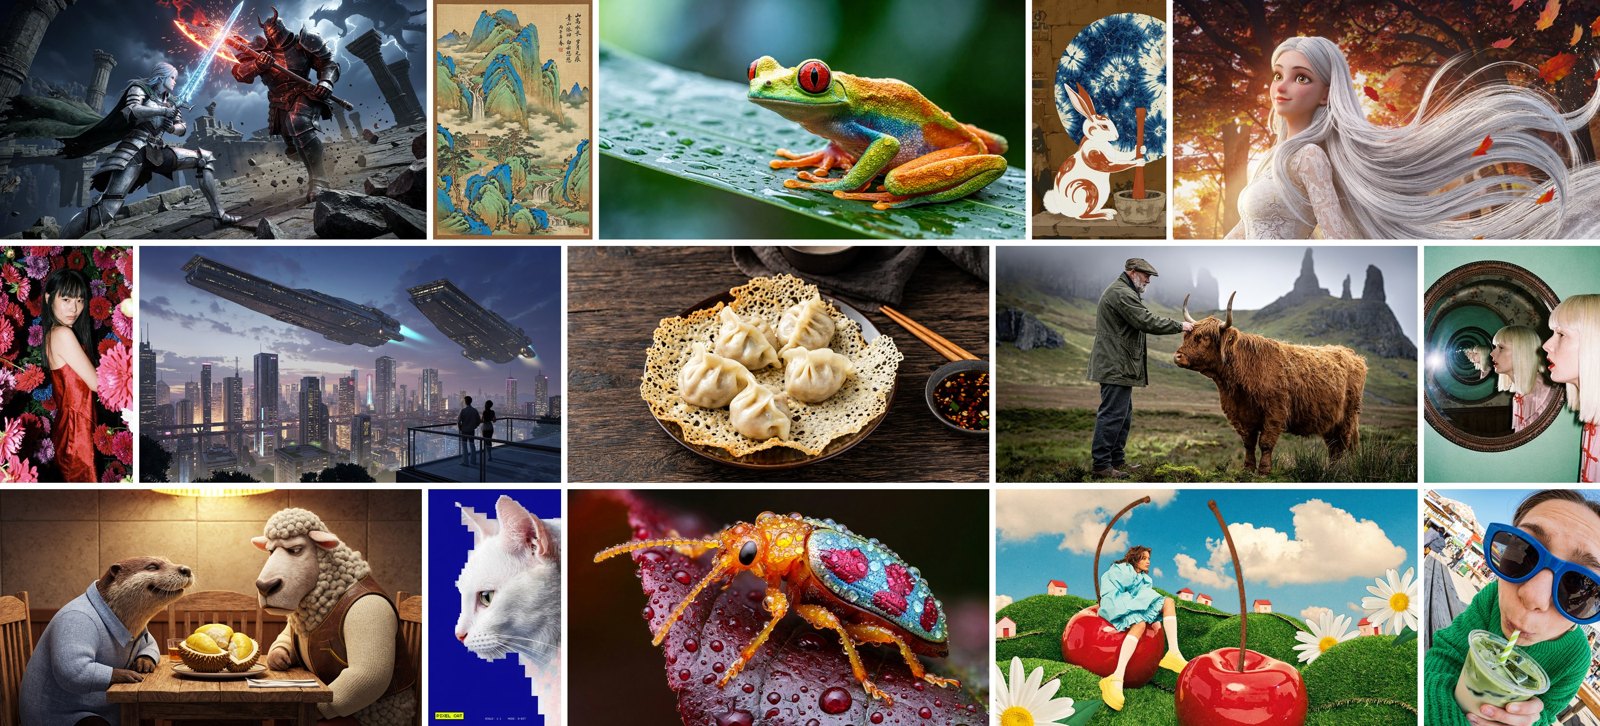 Ảnh: bộ ảnh mẫu do MiniMax H3-Image tạo, thu nhỏ để hiển thị. Nguồn: MiniMaxAI/MiniMax-H3-Image (Hugging Face).
Thẻ model còn khoe khả năng viết chữ trong ảnh có suy luận: giải đúng các câu đố logic bằng tiếng Trung và tiếng Anh rồi viết lời giải lên bảng. Đây là mảng mà nhiều model mở trước đây làm khá yếu.
3. Bám prompt tốt và dùng tới 16 ảnh tham chiếu
MiniMax tuyên bố H3-Image có khả năng bám prompt (prompt adherence) tốt nhất trong các model trọng số mở hiện nay. Điểm thực dụng hơn là tối đa 16 ảnh tham chiếu trong một lần chỉnh sửa. Mỗi ảnh được gọi theo thứ tự trong prompt (ảnh 1, ảnh 2…), ảnh đầu tiên là ảnh được sửa, các ảnh còn lại cung cấp nhân vật, đạo cụ, chất liệu hay bố cục.
Ví dụ trong thẻ model: từ một ảnh phòng trống và chín món nội thất riêng lẻ, model ghép thành một phòng khách hoàn chỉnh, ánh sáng và phối cảnh thống nhất.
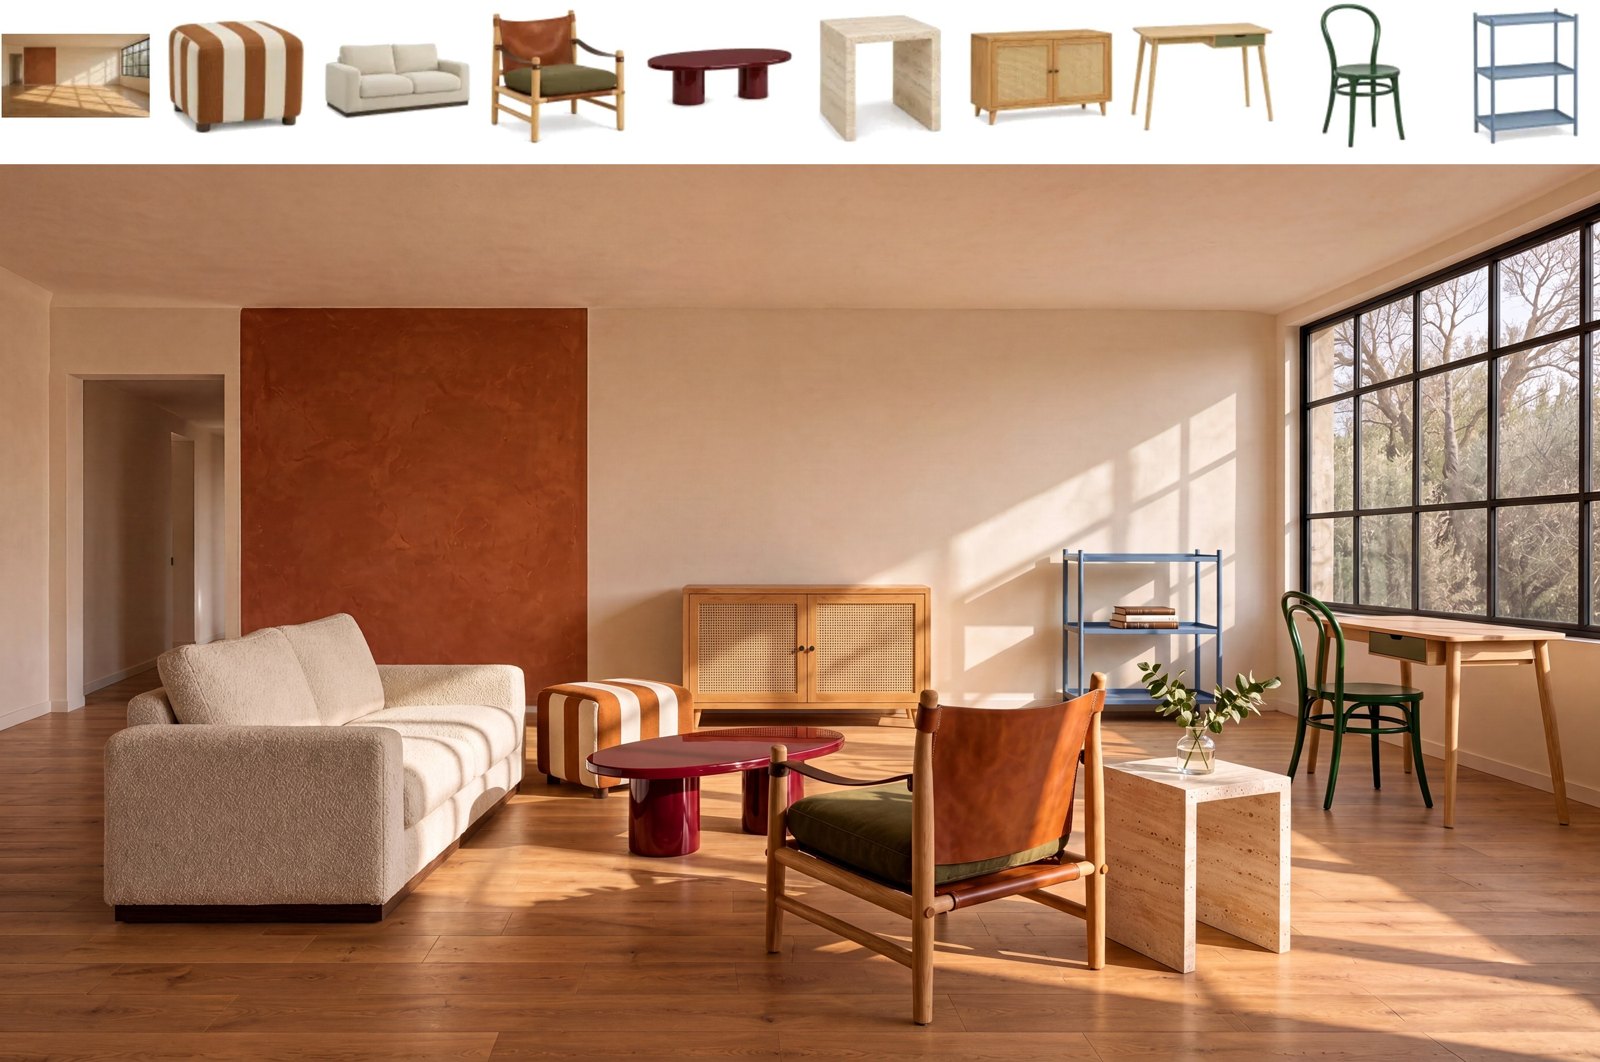 Ảnh: chỉnh sửa với mười ảnh tham chiếu (hàng trên) thành một phòng khách (bên dưới). Nguồn: MiniMaxAI/MiniMax-H3-Image (Hugging Face).
Với shop online, studio nội thất hay người làm quảng cáo, đây là kiểu việc rất hay gặp: có sẵn ảnh sản phẩm thật, cần đặt chúng vào một bối cảnh đẹp mà không phải chụp lại.
Thông số kỹ thuật dễ hiểu
| Hạng mục | Thông số (theo thẻ model) |
|---|---|
| Loại model | Tạo ảnh từ văn bản + chỉnh sửa ảnh, chung một checkpoint |
| Lõi DiT | 33,1 tỉ tham số, 50 lớp, BF16 |
| Text encoder | Qwen3-VL của MiniMax-H3 (dùng chung, không đổi) |
| Độ phân giải tốt nhất | Khoảng 16 MP (dải hiệu quả khoảng 4–20 MP) |
| Số bước lấy mẫu | 6 bước, guidance = 1, không có negative prompt |
| Ảnh tham chiếu | 1–16 ảnh |
| Dung lượng bản gốc | DiT khoảng 66 GB + text encoder khoảng 67 GB |
| Mở rộng prompt (tuỳ chọn) | MiniMax-H3-Image-PE, khoảng 17,9 GB (NVFP4) |
Một số kích thước 16 MP chuẩn: 4096 × 4096 (1:1), 4736 × 3552 (4:3), 5024 × 3360 (3:2), 5472 × 3072 (16:9), 3072 × 5472 (9:16, hợp cho Reels/Shorts) và 6272 × 2688 (21:9).
Vì sao cần "mở rộng prompt"?
H3-Image được huấn luyện để đọc mô tả tiếng Anh thật chi tiết về toàn bộ bức ảnh. Khi bạn gõ một câu ngắn (kể cả bằng tiếng Việt), API của MiniMax sẽ tự viết lại thành mô tả dài bằng một bước gọi là H3-Image-Context-IR trước khi tạo ảnh. Khi tự chạy model, bạn có thể dùng model mở rộng prompt MiniMax-H3-Image-PE để làm việc tương tự.
Ảnh dưới đây là ví dụ chính thức: cùng một yêu cầu, bên trái là ảnh chạy bằng máy chủ tự triển khai, bên phải là ảnh từ API của MiniMax, cả hai ở 4736 × 3552.
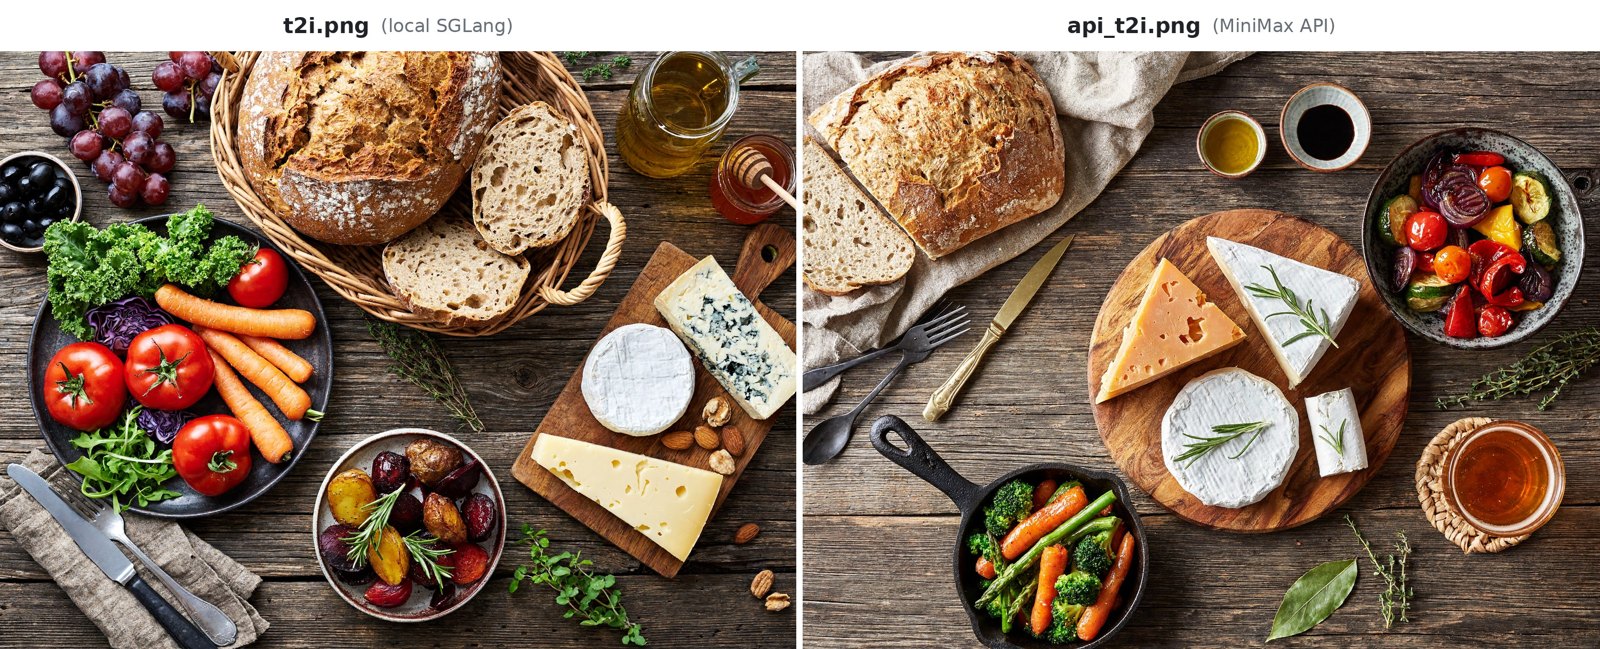 Ảnh: kết quả tự triển khai (trái) và qua API MiniMax (phải). Nguồn: MiniMaxAI/MiniMax-H3-Image (Hugging Face).
Nếu bạn muốn hiểu thêm cách viết mô tả sao cho model "hiểu ý", xem bài Cách viết prompt tạo ảnh AI hiệu quả. Nguyên tắc vẫn giống nhau: mô tả chủ thể, bối cảnh, ánh sáng, góc máy và phong cách rõ ràng. Điểm khác ở H3-Image là không có negative prompt, nên những gì muốn tránh bạn phải viết thẳng vào prompt chính (ví dụ "nền sạch, không có chữ").
Chạy MiniMax H3-Image trong ComfyUI
Theo tài liệu chính thức của ComfyUI, model có hai template dựng sẵn: "MiniMax-H3-Image: Text to Image" và "MiniMax-H3-Image: Image Edit". Cả hai cần ComfyUI 0.45.0 trở lên và gói template 0.11.104 trở lên. Nếu bạn mới làm quen với ComfyUI, hãy đọc trước bài ComfyUI là gì? Hướng dẫn cho người mới bắt đầu.
Bước 1: Cập nhật ComfyUI
Cập nhật ComfyUI lên bản mới nhất. Nếu mở Template Library mà không thấy hai template trên, gần như chắc chắn bản ComfyUI của bạn đã cũ. Người dùng Comfy Cloud sẽ có template sau khi ComfyUI ra bản ổn định tiếp theo.
Bước 2: Tải bốn file model
ComfyUI dùng bản rút gọn từ kho Comfy-Org, nhẹ hơn nhiều so với bản gốc:
| File | Dung lượng | Thư mục |
|---|---|---|
minimax_h3_image_pruned_int8_convrot.safetensors (DiT, INT8) |
21 GB | models/diffusion_models/ |
qwen3vl_32b_minimax_h3_int8_convrot.safetensors (text encoder) |
25,28 GB | models/text_encoders/ |
qwen3.5_9b_w4a8_gptq.safetensors (mở rộng prompt) |
7,34 GB | models/text_encoders/ |
minimax_h3_image_vae_fp16.safetensors (VAE) |
1,17 GB | models/vae/ |
Tổng cộng khoảng 55 GB ổ cứng, nên hãy chuẩn bị chỗ trống trước khi tải. Bộ mở rộng prompt trong template là bản Qwen3.5 9B gọn nhẹ để vừa cùng model chính trên một GPU, khác với bản PE chính thức của MiniMax.
Bước 3: Chạy với thông số mặc định
Cả hai template đã cài sẵn lịch lấy mẫu: sampler euler, scheduler simple, 6 bước, CFG = 1, denoise = 1. Bạn không nên đổi các thông số này. Với bản phục vụ qua API tự triển khai, MiniMax thậm chí từ chối (lỗi 400) nếu số bước khác 6 hoặc guidance khác 1.
Template tạo ảnh mở ở 4 MP trên khung vuông, thấp hơn độ phân giải tối ưu, để máy ít VRAM không bị tràn bộ nhớ. Khi GPU còn dư, bạn tăng dần lên 8 MP rồi 16 MP bằng bộ chọn độ phân giải. Template tạo ảnh để tắt bước mở rộng prompt (prompt đi thẳng vào model đúng như bạn gõ), còn template chỉnh sửa thì bật sẵn.
Bước 4: Chỉnh sửa với nhiều ảnh tham chiếu
Trong template Image Edit, ảnh nguồn là ảnh 1. Muốn thêm tham chiếu, bạn đặt thêm node Load Image và nối vào cả bước tạo prompt lẫn node conditioning. Prompt chỉ cần ngắn, ví dụ "thay chiếc xe trong ảnh 1 bằng chiếc xe trong ảnh 2". Ảnh tham chiếu không cần xử lý trước vì ComfyUI tự co giãn. Nếu bị tràn bộ nhớ, bật node Resize Image/Mask trong template và giảm megapixel.
Cần máy cỡ nào?
Tài liệu chính thức không đưa ra mức VRAM tối thiểu cụ thể. Có thể ước lượng từ dung lượng file: riêng DiT INT8 đã 21 GB, text encoder 25 GB, nên máy có 24 GB VRAM (RTX 4090, 5090) sẽ phải dựa vào cơ chế offload của ComfyUI và chạy ở độ phân giải thấp trước. Máy 8–12 GB VRAM gần như không thực tế để chạy bản đầy đủ. Trên trang Hugging Face đã có 17 bản lượng tử hoá (quantization) do cộng đồng làm, nên các bản nhẹ hơn sẽ còn xuất hiện, nhưng chất lượng mỗi bản cần tự kiểm tra.
Với máy chủ, MiniMax khuyến nghị SGLang, vLLM-Omni hoặc diffusers, hỗ trợ cả GPU NVIDIA (H200, RTX PRO 6000 Blackwell…) lẫn AMD Instinct MI350X, và có thể chia một yêu cầu ra nhiều GPU để giảm độ trễ.
Giấy phép: đọc kỹ trước khi dùng thương mại
Đây là phần quan trọng nhất nếu bạn định kiếm tiền từ model. H3-Image không dùng giấy phép mã nguồn mở kiểu Apache hay MIT mà dùng MiniMax-H3-Image Community License Agreement. Những điểm chính:
- Giới hạn lãnh thổ: giấy phép chỉ áp dụng ngoài Liên minh châu Âu, Anh, Hàn Quốc và Mỹ. Việt Nam nằm trong vùng được cấp phép, nhưng nếu khách hàng hoặc sản phẩm của bạn phục vụ các thị trường trên thì cần xin phép riêng.
- Cần văn bản cho phép riêng từ MiniMax nếu doanh thu năm của bạn (và công ty liên kết) vượt 1 triệu USD, hoặc nếu bạn cung cấp model dưới dạng dịch vụ (API, web) cho bên thứ ba.
- Sản phẩm thương mại dùng model phải hiển thị rõ "MiniMax-H3-Image" trên giao diện.
- Không được dùng model hoặc ảnh do nó tạo ra để huấn luyện, cải thiện một model AI khác (trừ chính H3-Image và các bản phái sinh của nó).
- Khi phân phối lại phải kèm bản giấy phép và file NOTICE theo mẫu.
Nói ngắn gọn: cá nhân, freelancer hay studio nhỏ ở Việt Nam tự chạy model để làm ảnh cho dự án của mình thì khá thoải mái. Nhưng nếu bạn định mở một website tạo ảnh cho người khác dùng dựa trên H3-Image, bạn phải xin phép MiniMax trước.
H3-Image đứng ở đâu so với các model ảnh mở khác?
Trong bài Toàn cảnh model tạo ảnh AI mã nguồn mở năm 2026, chúng tôi đã điểm qua SDXL, Flux, Qwen-Image và Z-Image. H3-Image bổ sung vào bức tranh đó vài điểm khác biệt rõ:
- Độ phân giải gốc cao nhất trong nhóm phổ biến: khoảng 16 MP so với 1–4 MP thường thấy.
- Tạo và sửa chung một model, thay vì phải dùng model edit riêng.
- Số ảnh tham chiếu nhiều (16 ảnh), hợp cho việc ghép sản phẩm, giữ nhân vật nhất quán.
- Đổi lại, model rất nặng: không phù hợp máy tầm trung như SDXL hay các bản Flux nhỏ, và giấy phép chặt hơn các model Apache 2.0.
So với P-H3-Image của Pruna AI (cũng dựng từ H3), H3-Image là bản "chính chủ", do chính MiniMax hậu huấn luyện riêng cho ảnh, có template ComfyUI chính thức và API đi kèm.
Ai nên dùng, dùng vào việc gì?
- Shop online, thương mại điện tử: ghép ảnh sản phẩm thật vào bối cảnh lifestyle bằng nhiều ảnh tham chiếu, xuất thẳng ảnh lớn để cắt banner, ảnh sàn, ảnh quảng cáo.
- Studio thiết kế, nội thất, kiến trúc: dựng phối cảnh từ ảnh phòng trống và ảnh đồ nội thất; biến bản render 3D chưa có vật liệu thành ảnh giống ảnh chụp.
- Game và minh hoạ: phác ý tưởng bối cảnh, nhân vật, đạo cụ ở độ phân giải cao.
- Người làm nội dung: ảnh bìa, thumbnail, poster khổ dọc 9:16 cho Reels, TikTok.
Nếu bạn muốn model "thuộc" một nhân vật, sản phẩm hay phong cách riêng, cách làm quen thuộc vẫn là huấn luyện LoRA. Trên Hugging Face đã có các adapter đầu tiên cho H3-Image. Bạn có thể tham khảo quy trình chuẩn bị dữ liệu trong bài Cách train LoRA nhân vật AI hoặc tìm hiểu dịch vụ train model LoRA của sydigi.com (Liên hệ để được giá tốt nhất).
Không có GPU mạnh? Dùng API tạo ảnh
Vì H3-Image cần phần cứng lớn, phần đông cá nhân và doanh nghiệp nhỏ sẽ tiện hơn khi gọi API tạo ảnh thay vì tự dựng máy chủ. Nếu bạn cần tích hợp tạo ảnh, sửa ảnh hay tạo video AI vào website, ứng dụng hoặc quy trình làm nội dung, hãy xem Lumina AI tại lumina.aiappviet.com. Lumina cung cấp API tạo ảnh và video AI, gọi được từ mọi ngôn ngữ lập trình, không cần tự quản lý GPU. Bài Tích hợp API tạo ảnh AI vào website trong 10 phút có ví dụ mã JavaScript/Node.js để bạn bắt đầu. Về chi phí sử dụng: Liên hệ để được giá tốt nhất.
Mẹo nhanh khi dùng H3-Image
- Viết prompt dài và cụ thể (tốt nhất bằng tiếng Anh), hoặc bật bước mở rộng prompt. Model được huấn luyện để đọc mô tả chi tiết về cả bức ảnh.
- Không có negative prompt: điều gì muốn tránh, hãy viết trực tiếp vào prompt chính.
- Bắt đầu ở 4 MP, kiểm tra bố cục rồi mới tăng lên 16 MP để tiết kiệm thời gian và VRAM.
- Giữ nguyên 6 bước và CFG = 1; đổi thông số này không làm ảnh đẹp hơn mà còn có thể gây lỗi.
- Gọi ảnh tham chiếu theo thứ tự (ảnh 1, ảnh 2…) và nói rõ mỗi ảnh đóng vai trò gì: nhân vật, sản phẩm, chất liệu hay bố cục.
Kết luận
MiniMax H3-Image là bước tiến đáng chú ý của model ảnh trọng số mở: ảnh 16 MP gốc, chỉ 6 bước lấy mẫu, tạo và sửa chung một model, tới 16 ảnh tham chiếu, và chạy được ngay trong ComfyUI. Điểm trừ là model rất nặng và giấy phép có giới hạn về lãnh thổ lẫn quy mô thương mại. Với người dùng ở Việt Nam, đây là công cụ đáng thử nếu bạn có GPU mạnh, còn không thì gọi qua API là con đường nhanh nhất để đưa chất lượng ảnh kiểu này vào công việc hằng ngày.
Nguồn tham khảo
- MiniMax – MiniMax H3-Image: Bringing 4K Image Generation into the 10-Second Era (11/11/2026)
- Hugging Face – MiniMaxAI/MiniMax-H3-Image (thẻ model, ảnh mẫu)
- Hugging Face – MiniMax-H3-Image Community License Agreement (10/11/2026)
- ComfyUI Docs – MiniMax-H3-Image: 16 MP text to image and image editing in ComfyUI
- MiniMax API – Image Generation Guide
- The Neuron – Everything That Happened in AI Today (11/11/2026)

Train model AI tạo ảnh, dựng hạ tầng API và biến ý tưởng AI thành phần mềm chạy thật.
Xem giới thiệu →