Pika H3 Flex và P-H3-Image: hệ sinh thái MiniMax H3 bùng nổ với video có tiếng và ảnh AI mã nguồn mở
Chỉ trong một tuần cuối tháng 10 và đầu tháng 11/2026, cộng đồng AI tạo video và tạo ảnh liên tục nhắc đến cùng một cái tên: MiniMax H3. Không phải vì MiniMax ra phiên bản mới, mà vì các nhóm khác bắt đầu "xây nhà" trên nền model này. Pika phát hành Pika H3 Flex, một model video kèm âm thanh với trọng số mở. Vài ngày sau, Pruna AI biến chính H3 thành P-H3-Image, một model tạo và chỉnh sửa ảnh mở có thể chạy trong ComfyUI. Nhóm Hao AI Lab (UC San Diego) thì đưa Pika H3 Flex vào FastVideo và công bố bản lượng tử hoá 4-bit.
Bài viết này tóm tắt những gì vừa ra mắt, mỗi model làm được gì, cần phần cứng ra sao, giấy phép cần chú ý điểm nào và người làm nội dung ở Việt Nam nên tận dụng thế nào. Mọi con số trong bài lấy từ trang chính thức hoặc tài liệu kỹ thuật của các nhóm phát triển, được dẫn nguồn ở cuối bài.
Lưu ý: các số liệu về tốc độ và chất lượng dưới đây là kết quả do chính nhà phát triển công bố, đo trên phần cứng của họ (thường là GPU trung tâm dữ liệu như H100, B200, GB200). Tốc độ trên máy cá nhân của bạn sẽ khác.
MiniMax H3 là gì và vì sao trở thành "nền móng" mới?
MiniMax giới thiệu H3 ngày 31/7/2026 như một model tạo nội dung đa phương thức tổng quát: hiểu ngữ cảnh gồm văn bản, ảnh, video và âm thanh, rồi tạo video có âm thanh stereo đi kèm. Ngày 3/8/2026, MiniMax công bố trọng số mở trên Hugging Face.
Phần được mở là H3-Base, gồm hai checkpoint dành cho hai nhóm việc:
- FL2VA (First/Last frame to Video-Audio): tạo video từ văn bản, hoặc từ ảnh khung đầu, khung cuối, hoặc cả hai.
- Ref2VA (Reference to Video-Audio): tạo video từ nhiều tham chiếu, tối đa 9 ảnh, 3 đoạn video và 3 đoạn âm thanh (tổng cộng không quá 12 file).
Theo tài liệu tự triển khai của MiniMax, bản mở cho ra video 4–15 giây, cạnh ngắn 768 pixel, 24 khung hình/giây, âm thanh stereo 32 kHz. Hai thành phần H3-Context-IR (hiểu ngữ cảnh phức tạp) và H3-Regenerate-2K (nâng lên 2K) không nằm trong bản mở, nên tự chạy H3-Base sẽ không tái tạo được toàn bộ quy trình trên nền tảng của MiniMax.
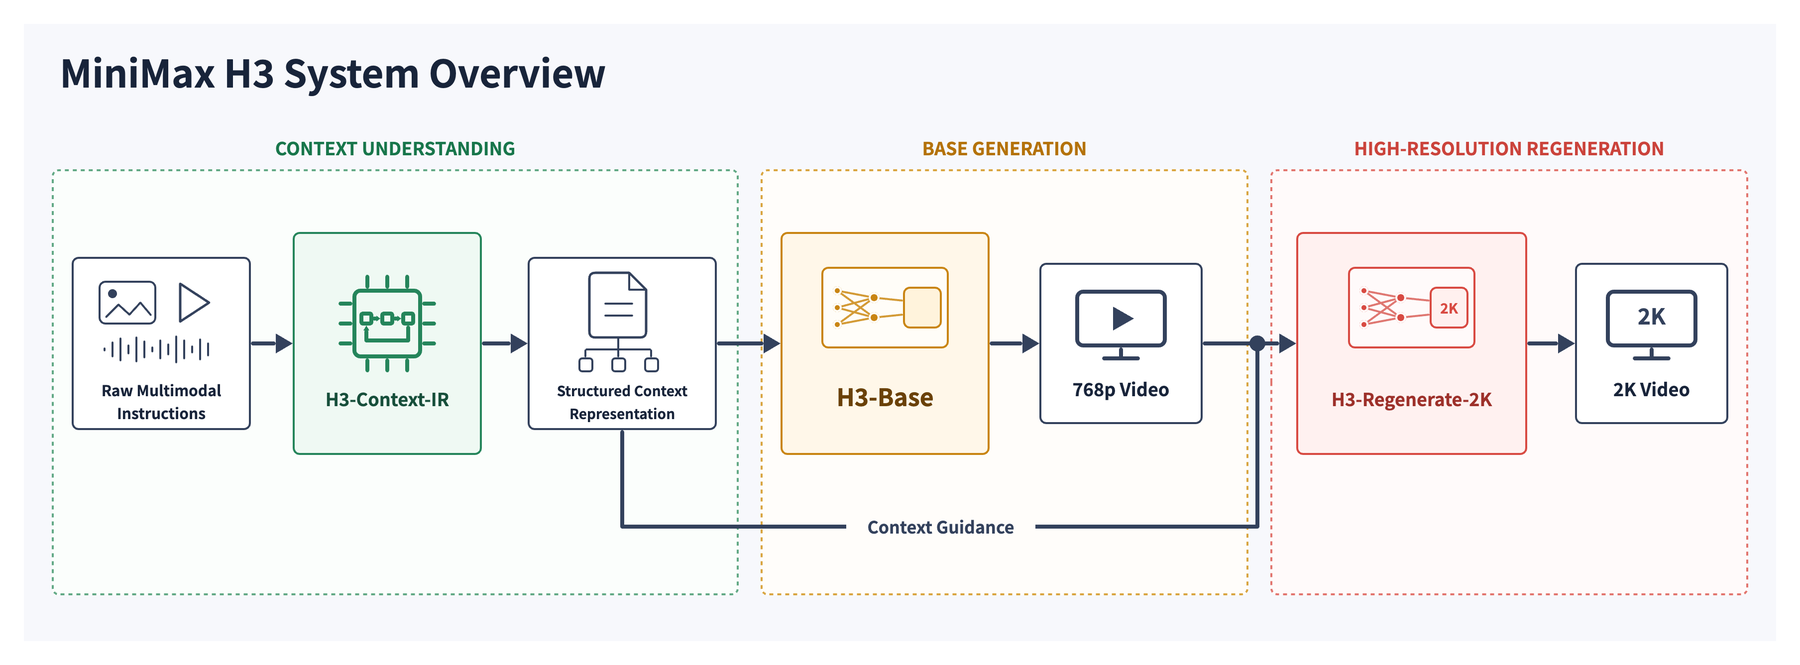 Ảnh: sơ đồ hệ thống MiniMax H3 gồm ba khối, trong đó bản trọng số mở chỉ có khối giữa H3-Base. Nguồn: MiniMaxAI/MiniMax-H3 trên Hugging Face.
Điểm khiến H3 trở thành nền móng hấp dẫn là nó vừa đủ mạnh, vừa có hệ sinh thái sẵn: ComfyUI hỗ trợ H3 ngay từ ngày phát hành trọng số, với các template text-to-video, image-to-video và reference-to-video có sẵn (yêu cầu ComfyUI 0.30.0 trở lên theo tài liệu của MiniMax). Khi model gốc đã mở và đã chạy được trong công cụ phổ biến, các nhóm khác có thể tập trung tinh chỉnh, tăng tốc và đóng gói, đúng như những gì đang diễn ra. Nếu bạn mới làm quen với ComfyUI, hãy đọc trước ComfyUI là gì? Hướng dẫn cho người mới.
Pika H3 Flex: video có tiếng, 6 bước lấy mẫu, trọng số mở
Ngày 29/10/2026, Pika ra mắt Pika H3 Flex. Đây là H3 được Pika huấn luyện thêm (post-train), không phải model làm lại từ đầu. Theo bài viết kỹ thuật của Pika, quy trình gồm ba giai đoạn:
- Tinh chỉnh có giám sát trên bộ dữ liệu video kèm âm thanh do Pika tự tuyển chọn theo tiêu chí thẩm mỹ.
- Chưng cất số bước (step distillation) bằng phương pháp PDMD, giảm từ 50 bước khử nhiễu xuống còn 6 bước.
- Học từ phản hồi và sở thích người dùng (ReFL và DPO), huấn luyện thành các adapter LoRA rồi gộp lại, không làm tăng số bước khi chạy.
Nếu bạn chưa rõ LoRA là gì, bài LoRA và Checkpoint khác nhau thế nào? giải thích khá dễ hiểu. Với H3 Flex, phần Pika công bố trên Hugging Face chính là hai adapter LoRA (FL2VA và Ref2VA, rank/alpha 128) cùng mã suy luận, đặt lên trên model gốc MiniMax-H3.
 Ảnh: banner Pika H3 Flex. Nguồn: Pika-Labs/Pika-H3-Flex trên Hugging Face.
Những gì chạy được trên máy của bạn và những gì chỉ có qua API
Đây là chỗ nhiều người dễ hiểu nhầm. Theo model card trên Hugging Face:
| Tính năng | Bản trọng số mở (tự chạy) | API của Pika |
|---|---|---|
| Độ phân giải gốc | 480p, 768p | 480p, 768p |
| Nâng lên 1080p, 2K, 4K | Không | Có |
| Âm thanh | Stereo trộn sẵn | Có thêm 5 stem tách riêng |
| Viết lại prompt tự động | Không | Có |
Năm stem âm thanh mà Pika tách được là lời thoại, nhạc nền, hiệu ứng (SFX), tiếng động (foley) và âm thanh môi trường. Với người làm video, đây là điểm đáng giá vì có thể chỉnh từng lớp âm thanh khi hậu kỳ thay vì nhận một file trộn sẵn. Pika cũng cho biết sẽ mở mã nguồn model upsampler (nâng độ phân giải) sau này, nhưng tại thời điểm viết bài thì phần này vẫn chỉ có trên API.
Về tác vụ, H3 Flex hỗ trợ tạo video từ văn bản, từ khung đầu/cuối, từ nhiều tham chiếu, và một số tác vụ chỉnh sửa như chuyển phong cách, chuyển chuyển động (motion transfer), thay vật thể, thay nhân vật, chỉnh sửa có chọn lọc một phần video.
Chất lượng: Pika nói gì, và nên đọc thế nào
Trong thông cáo ngày 29/10, Pika cho biết H3 Flex đứng #1 trong nhóm model trọng số mở và #7 tổng thể trên bảng xếp hạng text-to-video của DesignArena. Trong đánh giá nội bộ, Pika ghi nhận H3 Flex dẫn đầu ở các hạng mục giải phẫu cơ thể người, bố cục phức tạp và đồng bộ âm thanh.
Điều đáng quý là bài viết kỹ thuật của Pika cũng nêu rõ điểm yếu: vật lý, tính nhất quán qua nhiều cảnh và điều khiển tham chiếu phức tạp vẫn là những phần cần cải thiện, và ở một số hạng mục như ánh sáng, chất liệu hay cảnh hành động, các hệ thống khác vẫn được người đánh giá ưa chuộng hơn. Nói cách khác, đây là model mạnh để lặp nhanh ý tưởng, nhưng chưa phải "đũa thần" cho mọi cảnh quay.
Phần cứng cần có
- Gói suy luận của Pika chạy một yêu cầu trên một GPU. Các yêu cầu 480p và 768p được kiểm thử đạt trên H100 80GB. Yêu cầu lớn có thể cần bật
--cpu-offloadvà nhiều RAM hệ thống. - Các thành phần model gốc đi kèm chiếm khoảng 210 GB dung lượng, dù mỗi quy trình chỉ nạp phần transformer tương ứng.
- Với ComfyUI, đã có hướng dẫn chính thức và ba workflow mẫu (T2V, FL2VA, R2V), kèm trọng số LoRA định dạng Comfy (BF16).
Tóm lại, với card đồ hoạ phổ thông 8–16 GB VRAM, chạy H3 Flex cục bộ gần như không khả thi. Đây là lúc bản lượng tử hoá của FastVideo trở nên đáng chú ý.
FastVideo: tăng tốc H3 Flex, có bản 4-bit cho GPU Blackwell
Ngày 3/11/2026, nhóm Hao AI Lab (UC San Diego) công bố tích hợp Pika H3 Flex vào thư viện FastVideo. Theo bài viết của nhóm:
- Ở độ chính xác BF16, FastVideo nhanh hơn mã chính thức khoảng 2,4 lần trên một GPU, và khoảng 7 lần với clip 15 giây chạy trên bốn GPU.
- Nhóm phát hành bản NVFP4 (trọng số và activation 4-bit) được huấn luyện thêm bằng kỹ thuật chưng cất có nhận biết lượng tử hoá (QAD) để giữ chất lượng gần với bản gốc. Với bản này, một clip 480p dài 5 giây tạo xong trong khoảng 5,8 giây trên một GPU GB200.
- Bản NVFP4 nhắm tới phần cứng Blackwell, bao gồm cả máy cá nhân như RTX 5090 và DGX Spark. Trên một DGX Spark, clip 480p dài 5 giây (chế độ khung đầu/cuối) mất khoảng 59,5 giây.
- FastVideo cũng chạy được Open-H3-Regenerate-2K của NVIDIA để nâng video 768p của dòng H3 lên 2560×1440.
Điểm cần nhớ: NVFP4 bắt buộc GPU Blackwell. Nếu bạn dùng card đời RTX 30 hay 40, bản này không áp dụng được.
P-H3-Image: biến model video thành model tạo ảnh
Cũng trong ngày 3/11/2026, Pruna AI phát hành P-H3-Image, model tạo ảnh và chỉnh sửa ảnh với trọng số mở, xây trên MiniMax-H3. Ý tưởng nghe có vẻ lạ: lấy model video để làm model ảnh. Pruna giải thích rằng để giữ các khung hình nhất quán, model video phải học cách vật thể trông ra sao từ nhiều góc, ánh sáng rơi trên chất liệu thế nào, cơ thể chuyển động ra sao. Đó là nền tảng tốt cho ảnh chân thực.
Tuy nhiên, theo Pruna, H3 nguyên bản khi tạo ảnh đơn thì cho kết quả mềm và mờ, đồng thời quá nặng để đa số người dùng tự chạy. Họ đã làm lại gần như mọi thành phần:
- Bộ viết lại prompt (prompt upsampler) nhỏ dựa trên Qwen3.5-9B, biến yêu cầu ngắn thành prompt mà H3 hiểu tốt.
- Bộ mã hoá văn bản được chưng cất từ 32B xuống 4B tham số, giảm từ 67 GB còn 9 GB.
- Giảm số bước từ 50 xuống 8 bước bằng chưng cất DMD.
- Bộ giải mã mới chuyển một khung hình thành một ảnh sắc nét, thay cho bộ giải mã video vốn cho ảnh mờ khi chỉ có một khung.
- Lượng tử hoá 8-bit và 4-bit.
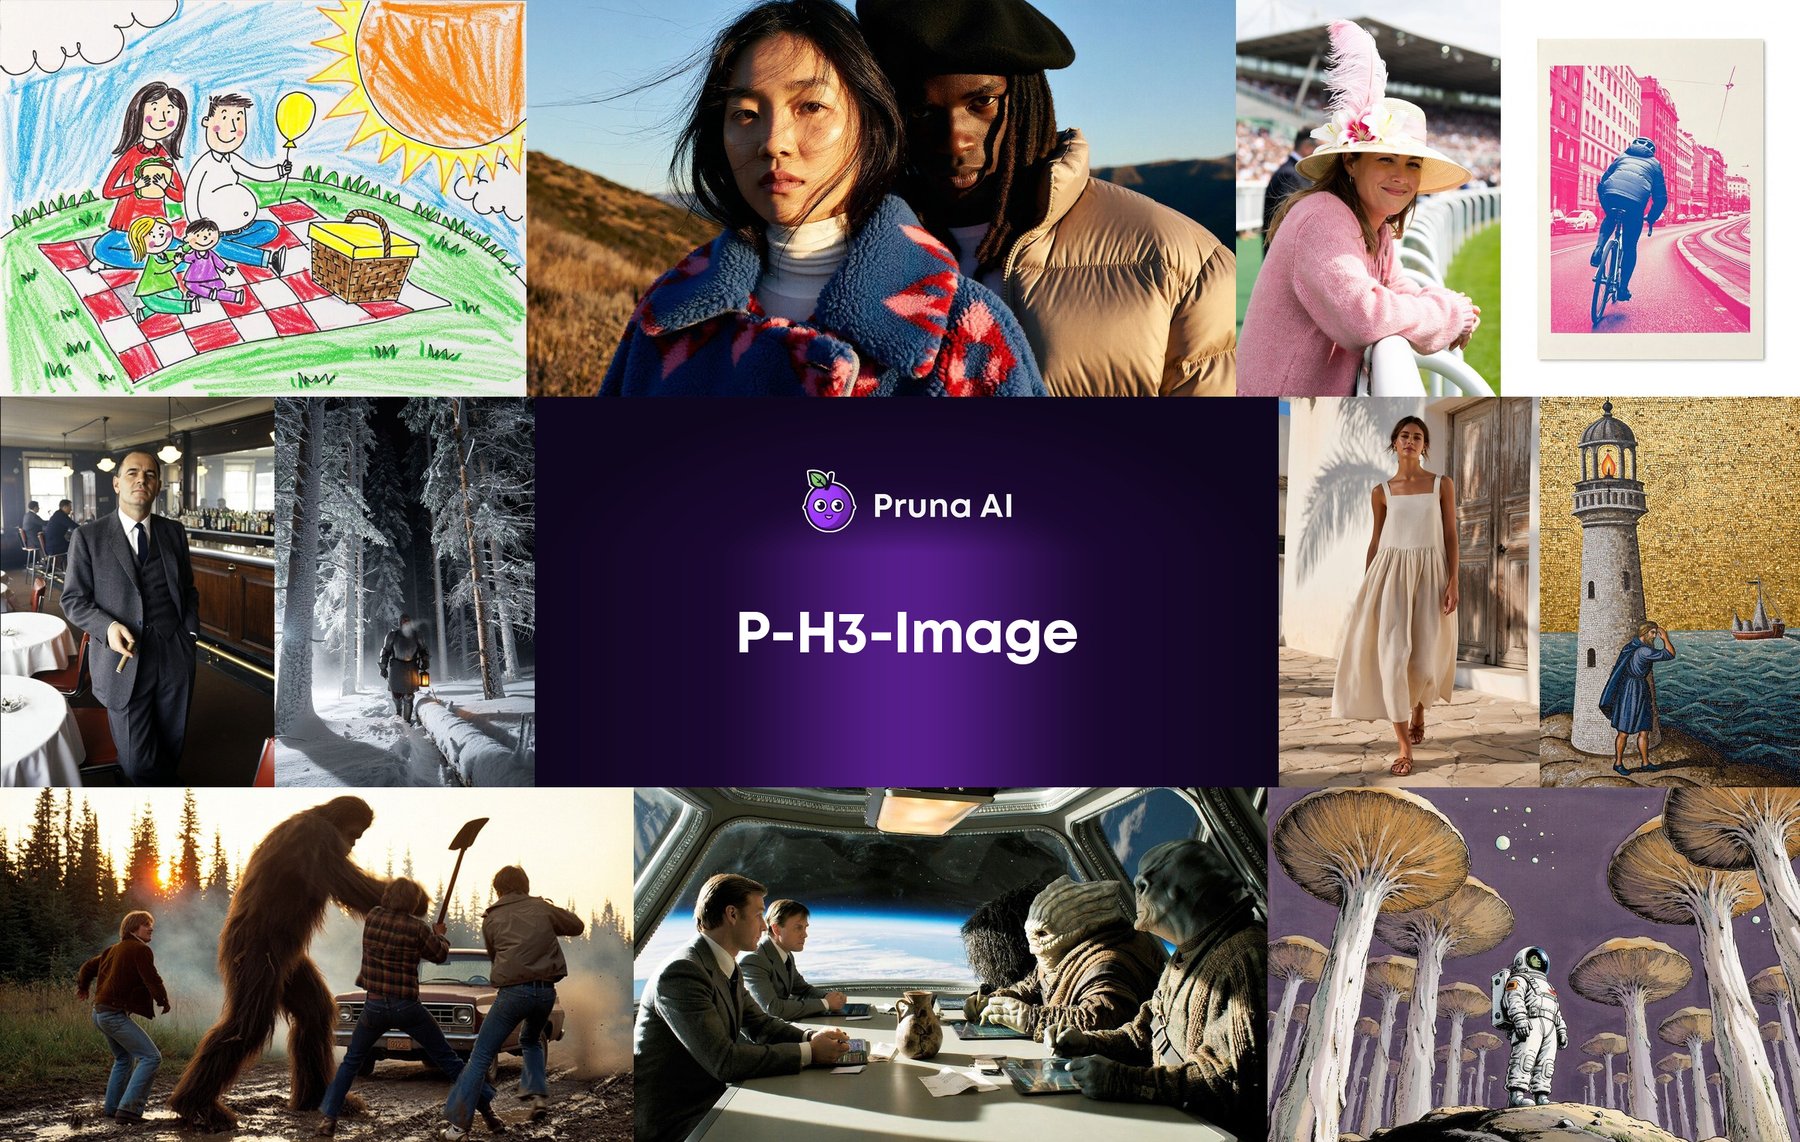 Ảnh: ảnh mẫu đa phong cách do P-H3-Image tạo ra. Nguồn: PrunaAI/P-H3-Image trên Hugging Face.
Thông số đáng chú ý
Theo bài công bố của Pruna:
| Hạng mục | MiniMax-H3 gốc | P-H3-Image |
|---|---|---|
| Dung lượng tải (bản nhỏ nhất) | 143 GB | 20 GB (4-bit) |
| Thời gian ảnh 4 MP, GPU B200, bf16 | 12,4 giây | 2,6 giây |
| Thời gian ảnh 4 MP, GPU L40S 48 GB | 19 giây (bf16, offload) | 6,3 giây (4-bit) |
| VRAM tối đa ở 8 MP | – | khoảng 21 GB (4-bit) |
Model tạo ảnh từ 2 đến 16 megapixel; Pruna khuyên dùng 8 MP để có chất lượng tốt nhất, 4 MP nếu cần nhanh. Bản bf16 chạy qua thư viện Diffusers cần GPU rất lớn (khoảng 100 GB ở 8 MP khi bật bộ viết lại prompt), nên với máy nhỏ hơn, Pruna khuyên dùng bản lượng tử hoá cho ComfyUI (kho PrunaAI/P-H3-Image-Comfy). ComfyUI hỗ trợ sẵn, không cần cài custom node.
Chỉnh sửa và ghép nhiều ảnh tham chiếu
Kế thừa khả năng dựng video từ ảnh tham chiếu của H3, P-H3-Image có thể chỉnh sửa ảnh bằng lời và ghép tới 8 ảnh tham chiếu vào một cảnh. Ví dụ Pruna đưa ra là ghép tám bức chân dung thuộc phạm vi công cộng thành một bữa tiệc tối chỉ từ một câu yêu cầu.
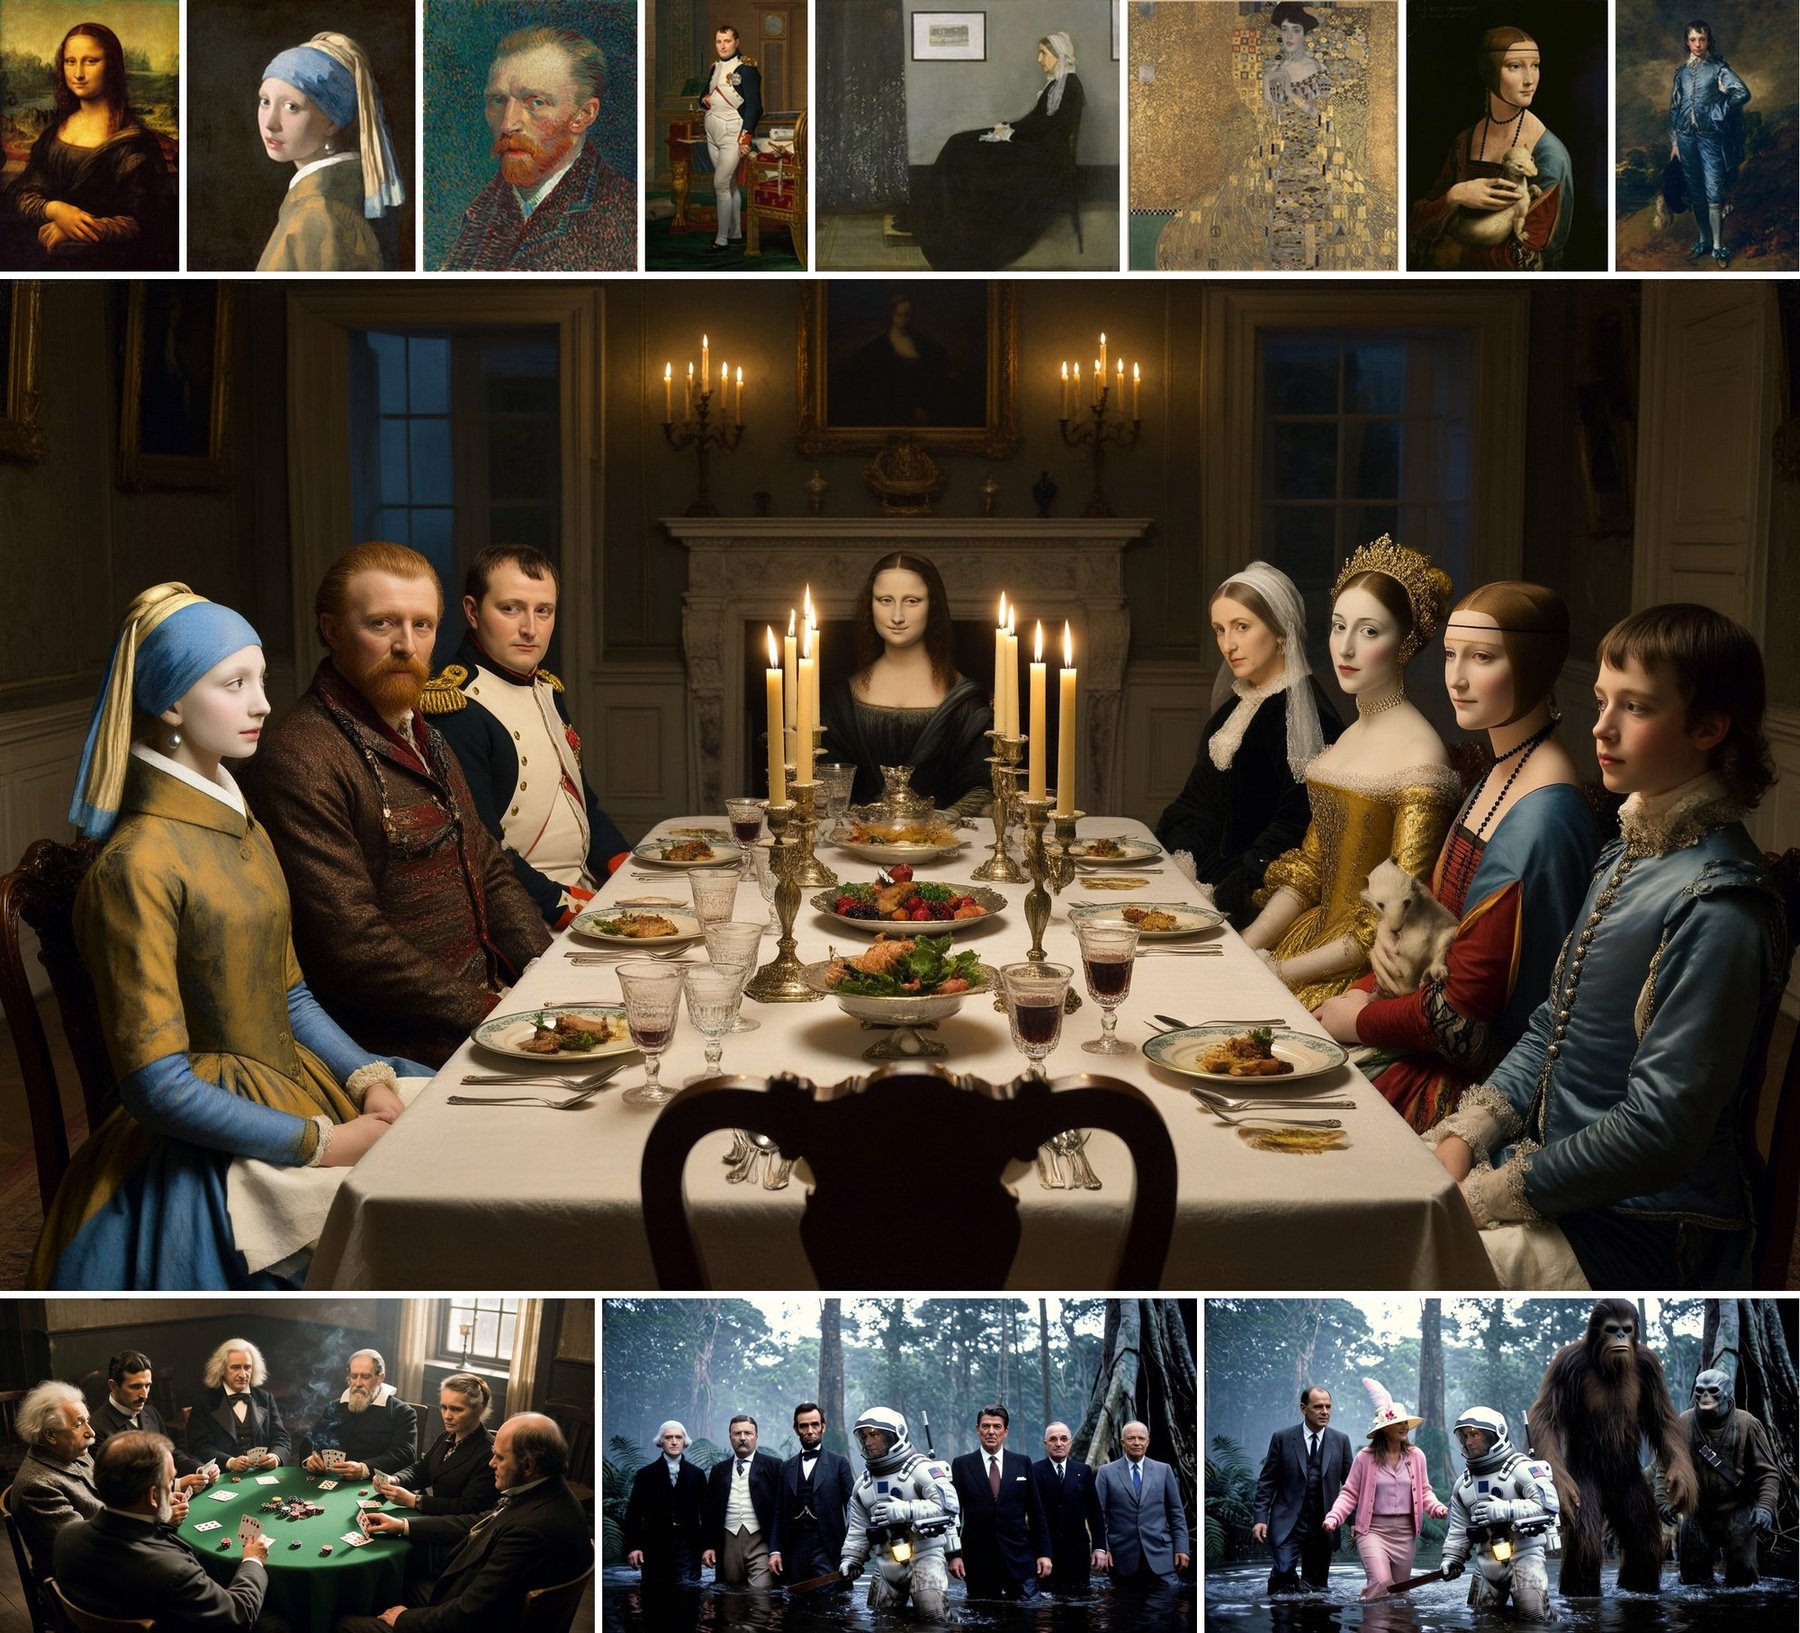 Ảnh: hàng trên là 8 ảnh tham chiếu, bên dưới là các cảnh được ghép bởi P-H3-Image. Nguồn: PrunaAI/P-H3-Image trên Hugging Face.
Điểm mạnh, điểm yếu theo chính Pruna
- Mạnh: ảnh phóng sự và biên tập, chân dung có kết cấu da thật, khung hình phim, khung hình anime, tranh vẽ, bản in, thiết kế đồ hoạ có chữ ngắn.
- Yếu: prompt quá ngắn, quá dài hoặc nhiều từ "thổi phồng" làm kết quả kém đi; bàn tay, người nhỏ ở hậu cảnh và chi tiết nhỏ có thể bị méo, nhất là dưới 8 MP; chữ nhỏ hoặc dày đặc (như đoạn văn, code) không đáng tin cậy.
Mẹo viết prompt cho P-H3-Image
Pruna đưa ra vài nguyên tắc rất thực tế, áp dụng được cho nhiều model khác:
- Câu đầu nói rõ đây là loại ảnh gì, ví dụ "ảnh của một nhiếp ảnh gia đường phố" hay "một khung hình từ phim hoạt hình anime".
- Mô tả một cảnh duy nhất: góc nhìn, một chủ thể chính, hướng ánh sáng.
- Chữ cần xuất hiện trong ảnh thì đặt trong ngoặc kép và giữ ngắn.
- Bỏ các từ như "stunning", "8k", "masterpiece". Theo Pruna, chúng làm ảnh bóng bẩy và quá bão hoà màu.
- Khi chỉnh sửa, mô tả kết quả cuối cùng và nói rõ phần nào phải giữ nguyên.
Muốn tìm hiểu kỹ hơn cách viết prompt, bạn có thể xem Cách viết prompt tạo ảnh AI hiệu quả cho SDXL và Flux.
Giấy phép: đọc kỹ trước khi dùng thương mại
Cả Pika H3 Flex lẫn P-H3-Image đều dùng trọng số dựa trên H3 nên chịu MiniMax H3 Community License Agreement. Một số điểm đã được các nguồn công bố:
- Giấy phép loại trừ Hoa Kỳ, Liên minh châu Âu, Vương quốc Anh và Hàn Quốc khỏi phạm vi được phép, trừ khi có giấy phép riêng từ MiniMax (theo Pruna và Tech Times).
- Sản phẩm xây dựng trên P-H3-Image phải hiển thị dòng "Powered by MiniMax H3" (theo Pruna).
- Một số thành phần đi kèm như bộ mã hoá văn bản gốc Qwen, bộ viết lại prompt của Pruna, và mã ví dụ của Pika dùng Apache 2.0; node ComfyUI của Pruna dùng giấy phép MIT. Nhưng giấy phép của mã nguồn không áp dụng cho trọng số model.
Việt Nam không nằm trong danh sách loại trừ mà các nguồn trên nêu, nhưng giấy phép còn nhiều điều khoản khác, và nếu khách hàng hoặc thị trường của bạn ở các khu vực bị loại trừ thì cần đặc biệt cẩn trọng. Hãy đọc toàn văn giấy phép trên Hugging Face trước khi đưa vào sản phẩm thương mại.
Vì sao đây là tin đáng chú ý?
Nhìn rộng hơn, chuỗi phát hành này cho thấy vài xu hướng mà chúng tôi đã nhắc trong bài Xu hướng AI tạo video năm 2026 và Toàn cảnh model tạo ảnh AI mã nguồn mở 2026:
- Model video mở trở thành nền tảng chung. Giống cách SDXL hay Flux từng sinh ra cả hệ sinh thái checkpoint và LoRA, H3 đang được nhiều nhóm khác nhau tinh chỉnh cho những mục đích riêng: Pika làm video nhanh hơn, Pruna làm ảnh, FastVideo làm tăng tốc.
- Âm thanh trở thành mặc định. Video tạo ra không còn "câm"; lời thoại, nhạc, tiếng động được tạo cùng lúc và đồng bộ với hình.
- Chưng cất và lượng tử hoá là chìa khoá. Giảm từ 50 xuống 6–8 bước, nén xuống 4-bit giúp model khổng lồ tiến gần hơn tới máy cá nhân, dù hiện vẫn cần GPU cao cấp.
- ComfyUI tiếp tục là "cửa ngõ" thử nghiệm. Cả H3, H3 Flex và P-H3-Image đều có workflow ComfyUI ngay khi ra mắt.
Người làm nội dung nên làm gì?
- Có GPU mạnh (từ 24 GB VRAM trở lên): thử P-H3-Image bản 4-bit trong ComfyUI cho ảnh chân thực, ảnh sản phẩm, poster có chữ ngắn.
- Có GPU Blackwell như RTX 5090: thử bản NVFP4 của Pika H3 Flex qua FastVideo để tạo clip ngắn có âm thanh.
- Máy cấu hình phổ thông hoặc cần tạo số lượng lớn: dùng API thay vì tự vận hành GPU. Bạn có thể dùng các API tạo ảnh và tạo video AI tại Lumina, hoặc xem API tạo ảnh AI và API tạo video AI của SDG. Nếu muốn tích hợp vào website, tham khảo bài Tích hợp API tạo ảnh AI vào website trong 10 phút.
- Doanh nghiệp cần phong cách riêng: xem dịch vụ train model & LoRA – liên hệ để được giá tốt nhất.
Dù chọn cách nào, hãy kiểm tra giấy phép model và bản quyền ảnh tham chiếu trước khi dùng cho mục đích thương mại.
Kết luận
MiniMax H3 mở trọng số từ tháng 8, nhưng phải đến tuần này hệ sinh thái quanh nó mới thực sự bùng nổ. Pika H3 Flex đưa video có tiếng xuống còn 6 bước lấy mẫu với trọng số mở. P-H3-Image chứng minh một model video có thể trở thành model ảnh chân thực, nhỏ gọn hơn nhiều lần. FastVideo đưa cả hai tiến gần hơn tới GPU cá nhân. Rào cản lớn nhất hiện nay là phần cứng và giấy phép, nên với đa số người làm nội dung, cách thực tế nhất là theo dõi sát, thử nghiệm khi có điều kiện, và dùng API khi cần sản xuất ổn định. Theo dõi chuyên mục Tin tức AI trên SDG để cập nhật các bước tiếp theo.
Nguồn tham khảo
- MiniMax – MiniMax H3: An Open Model Breaking the Boundaries Between Tasks and Modalities (31/7/2026)
- MiniMax – Open General Intelligence: MiniMax H3 Is Now Open Source (3/8/2026)
- MiniMax – Run and self-host MiniMax H3
- Hugging Face – MiniMaxAI/MiniMax-H3
- Pika – Pika H3 Flex Technical Deep Dive (29/10/2026)
- Business Wire – Pika Launches Pika H3 Flex, a Video Model Built for Professional Iteration (29/10/2026)
- Hugging Face – Pika-Labs/Pika-H3-Flex
- Hao AI Lab @ UCSD – Pika H3 Flex in FastVideo: 7x Faster, and Near Real Time in 4-bit (3/11/2026)
- Pruna AI – P-H3-Image: Turning a SOTA Video Model into an Efficient Open Image Model (3/11/2026)
- Hugging Face – PrunaAI/P-H3-Image
- Tech Times – MiniMax H3 Open Weights Exclude US, EU, UK, and Korea From Local Deployment (4/8/2026)

Train model AI tạo ảnh, dựng hạ tầng API và biến ý tưởng AI thành phần mềm chạy thật.
Xem giới thiệu →