Cách train LoRA nhân vật AI: từ chuẩn bị dữ liệu đến kiểm thử
Bạn đã tạo được một nhân vật AI ưng ý, nhưng sang ảnh thứ hai thì khuôn mặt đã khác, kiểu tóc lệch, trang phục cũng đổi. Đây là vấn đề quen thuộc nhất khi làm truyện tranh, mascot thương hiệu hay KOL ảo bằng AI. Cách phổ biến nhất để giữ một nhân vật nhất quán qua hàng trăm bức ảnh là train LoRA nhân vật.
Bài này đi từ khái niệm đến thực hành: LoRA là gì, khi nào nên train, chọn base model, cần phần cứng gì, chuẩn bị dữ liệu ra sao, viết caption, đặt thư mục, cài công cụ, chỉnh tham số, theo dõi quá trình train, thử trong ComfyUI và sửa các lỗi hay gặp. Những con số trong bài là điểm khởi đầu tham khảo, không phải công thức đúng cho mọi trường hợp. Mỗi bộ dữ liệu sẽ cần thử và điều chỉnh một chút.
1. LoRA là gì? Giải thích bằng hình
LoRA (Low-Rank Adaptation) là kỹ thuật tinh chỉnh mô hình được nhóm nghiên cứu của Microsoft giới thiệu năm 2021 trong bài báo LoRA: Low-Rank Adaptation of Large Language Models. Ý tưởng ban đầu dành cho mô hình ngôn ngữ, sau đó được cộng đồng áp dụng rộng rãi cho mô hình tạo ảnh như Stable Diffusion và Flux.
Nói đơn giản: thay vì sửa toàn bộ hàng tỷ tham số của mô hình gốc, LoRA giữ nguyên mô hình gốc và chỉ học thêm hai ma trận nhỏ (thường gọi là A và B). Khi tạo ảnh, phần "chênh lệch" do hai ma trận này tạo ra được cộng vào mô hình gốc.
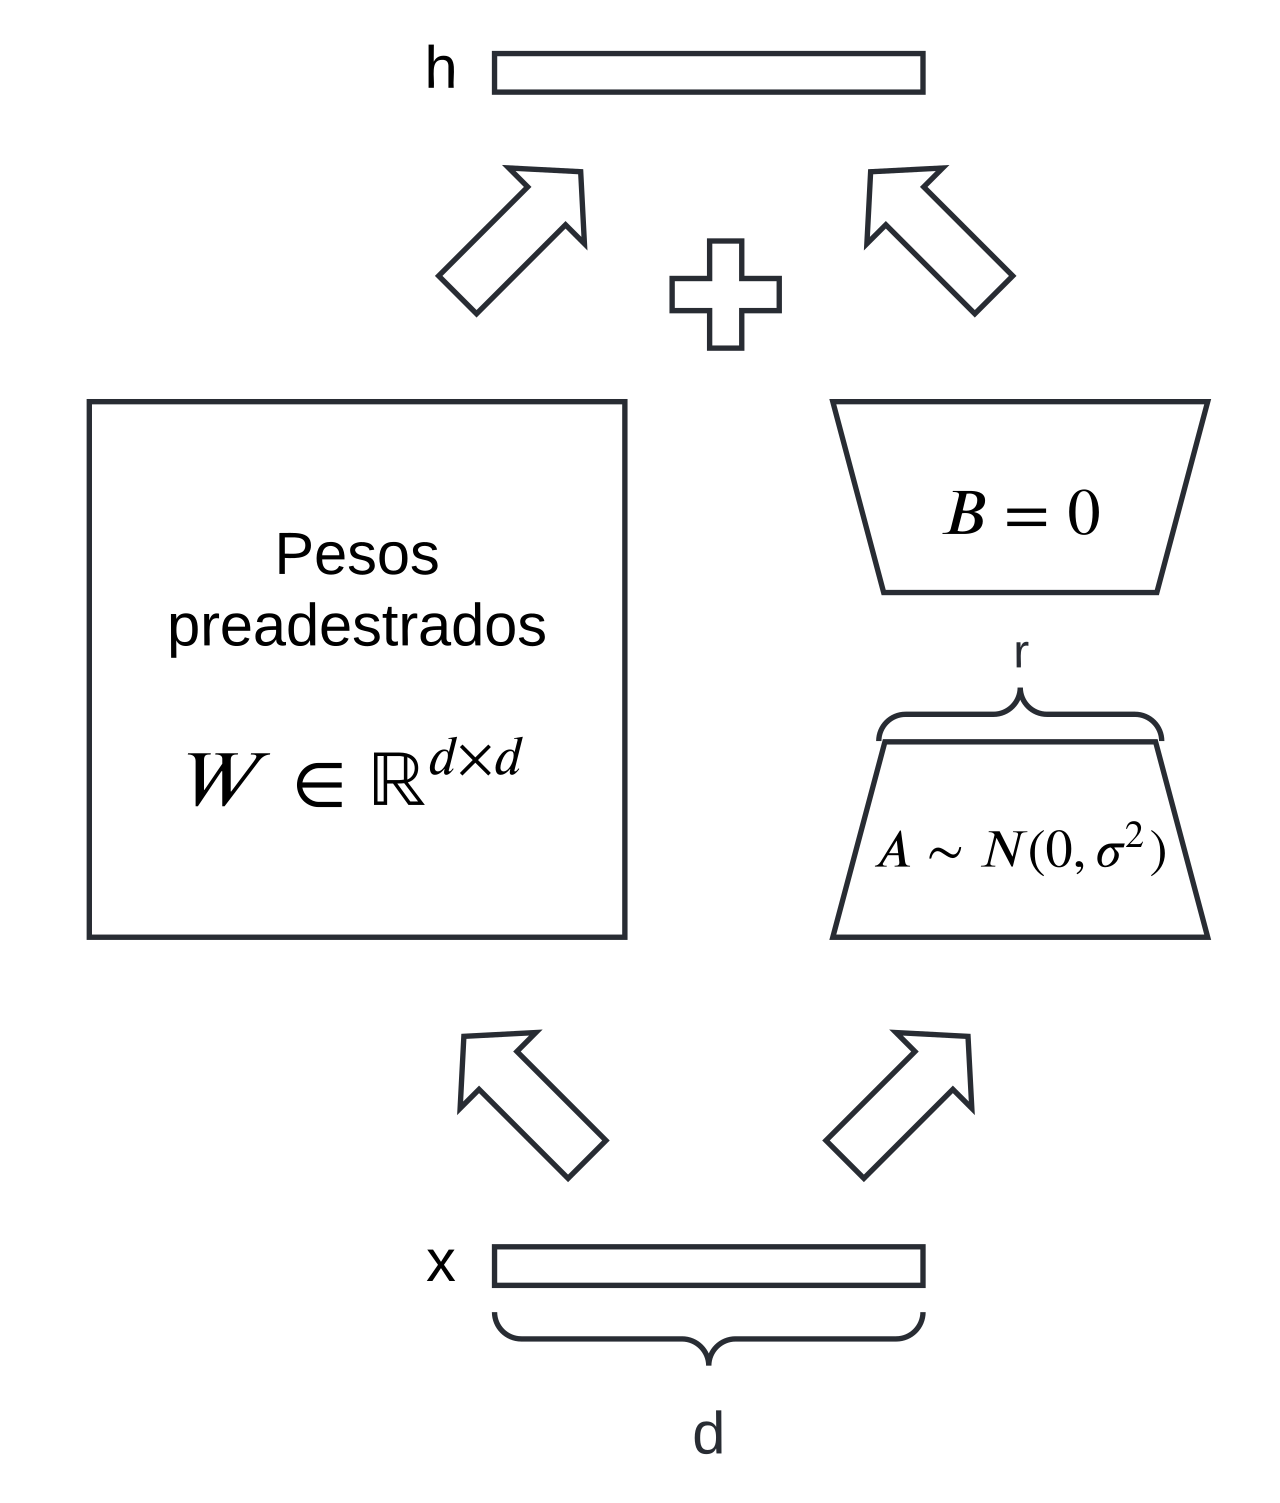 Sơ đồ kiến trúc LoRA: trọng số gốc được đóng băng, chỉ hai ma trận hạng thấp A và B được học. Nguồn: Wikimedia Commons – LoRA.svg, tác giả LauAI, giấy phép CC BY-SA 4.0.
Vì sao hai ma trận nhỏ lại đủ? Một ma trận lớn có thể được xấp xỉ bằng tích của hai ma trận "mỏng" hơn nhiều. Con số quyết định độ "mỏng" chính là rank (hạng), tham số bạn sẽ gặp lại trong phần cấu hình. Rank càng cao thì LoRA càng có nhiều "chỗ" để ghi nhớ chi tiết, nhưng file nặng hơn và dễ học vẹt hơn.
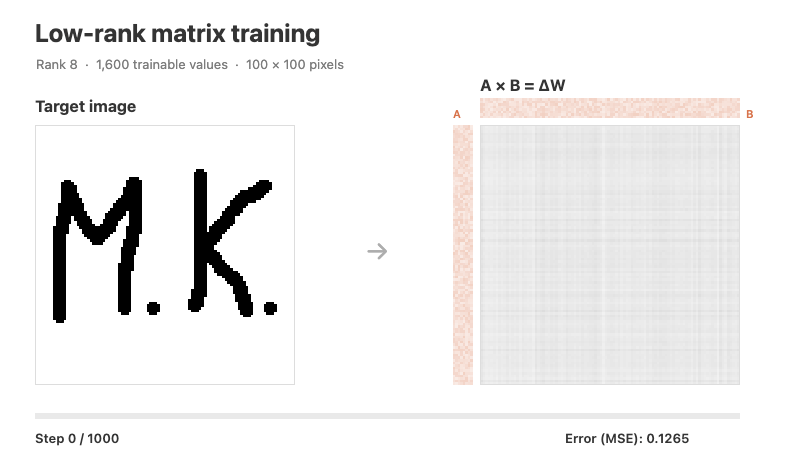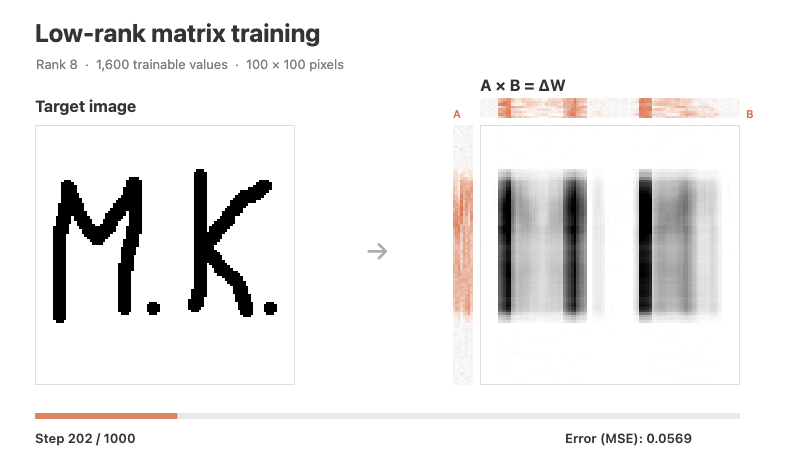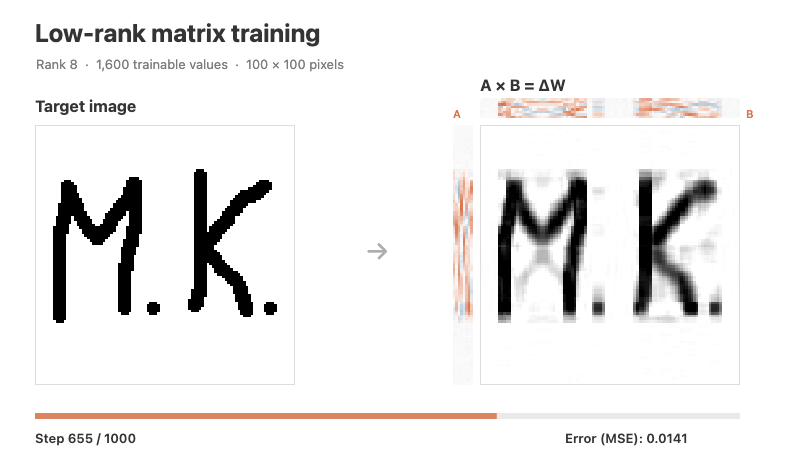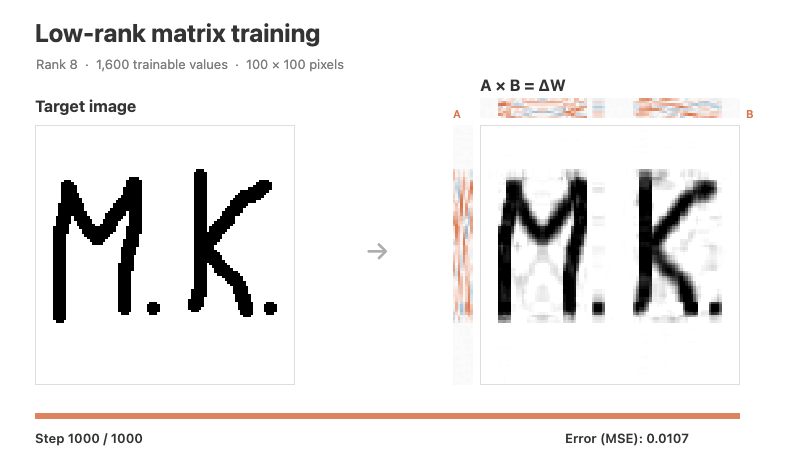 Minh hoạ xấp xỉ hạng thấp: ma trận 100×100 được tái tạo dần bằng tích hai ma trận nhỏ. Nguồn: Wikimedia Commons, tác giả Matejkoncal, giấy phép CC BY-SA 4.0.
Kết quả thực tế: một LoRA nhân vật thường chỉ nặng vài chục đến vài trăm MB (tuỳ base model và rank), trong khi checkpoint gốc nặng nhiều GB. Bạn có thể bật, tắt hoặc chỉnh độ mạnh của LoRA mỗi khi tạo ảnh. Nếu chưa rõ LoRA khác checkpoint thế nào, hãy đọc thêm bài LoRA và Checkpoint khác nhau thế nào.
2. Khi nào nên train LoRA nhân vật?
Train LoRA tốn thời gian chuẩn bị dữ liệu và thử nghiệm, vì vậy chỉ nên làm khi thật sự cần:
- Nên train khi bạn cần cùng một nhân vật (mascot, nhân vật truyện, người mẫu ảo) xuất hiện trong nhiều bối cảnh, tư thế, trang phục khác nhau và phải nhận ra ngay đó là "cùng một người".
- Nên train khi prompt dài và kỹ đến đâu cũng không giữ được các đặc điểm riêng như vết sẹo, màu mắt hay kiểu tóc đặc trưng.
- Chưa cần train khi bạn chỉ cần vài ảnh. Lúc đó hãy thử viết prompt thật kỹ (xem cách viết prompt tạo ảnh AI hiệu quả) hoặc dùng các công cụ tham chiếu ảnh như IP-Adapter.
- Không nên train trên khuôn mặt người thật khi chưa có sự đồng ý của họ (xem mục 13).
3. Chọn base model: SD1.5, SDXL hay Flux?
LoRA luôn gắn với dòng mô hình mà nó được train. Một LoRA train trên SDXL không dùng được cho SD1.5 hay Flux. Vì vậy hãy chọn base model trước tiên.
| Base model | Độ phân giải train thường dùng | Ưu điểm | Nhược điểm |
|---|---|---|---|
| SD 1.5 | 512×512 | Nhẹ, train nhanh, nhiều tài nguyên cộng đồng | Chất lượng và độ chi tiết thấp hơn các dòng mới |
| SDXL (và các bản phái sinh như Pony, Illustrious) | 1024×1024 | Cân bằng tốt giữa chất lượng và tài nguyên, hệ sinh thái lớn | Cần nhiều VRAM hơn SD1.5 |
| Flux (FLUX.1-dev và các bản mới hơn) | khoảng 1024 | Hiểu prompt tốt, ảnh chi tiết, giữ mặt tốt | Rất nặng, cần GPU mạnh; lưu ý giấy phép từng bản |
Gợi ý thực tế:
- Làm nhân vật anime hoặc minh hoạ: chọn checkpoint SDXL phái sinh cùng phong cách bạn sẽ dùng khi tạo ảnh.
- Làm nhân vật tả thực, cần hiểu prompt phức tạp: cân nhắc Flux, nhưng hãy đọc kỹ giấy phép của bản Flux bạn dùng, vì một số bản (ví dụ FLUX.1-dev) có giấy phép phi thương mại cho trọng số. Đầu ra dùng thương mại được hay không cần kiểm tra trực tiếp trên trang mô hình.
- Máy yếu, muốn học cách làm trước: bắt đầu với SD1.5.
Tổng quan các mô hình mở hiện có: xem bài toàn cảnh model tạo ảnh AI mã nguồn mở 2026.
4. Phần cứng, VRAM và lựa chọn train trên cloud
VRAM (bộ nhớ của card đồ hoạ) là giới hạn lớn nhất. Các con số dưới đây là mức tham khảo thường gặp trong cộng đồng, không phải thông số chính thức. Mức thực tế phụ thuộc rất nhiều vào tối ưu như gradient checkpointing, optimizer 8-bit, cache latent hay lượng tử hoá model:
- SD1.5: thường train được trên GPU khoảng 6–8 GB VRAM.
- SDXL: thường cần khoảng 12 GB trở lên để thoải mái; 8–10 GB có thể chạy được nếu bật nhiều tối ưu, nhưng chậm.
- Flux: file cấu hình mẫu của AI Toolkit có tên
train_lora_flux_24gb.yaml, tức là được thiết kế cho GPU 24 GB. Trên card nhỏ hơn cần lượng tử hoá và các mẹo tiết kiệm bộ nhớ.
Card NVIDIA là lựa chọn được hỗ trợ tốt nhất. README của AI Toolkit ghi yêu cầu là "Nvidia GPU with enough ram". Card AMD hoặc Mac Apple Silicon có thể chạy với một số công cụ, nhưng thường phải tự xử lý nhiều hơn.
Không có GPU mạnh? Bạn có thể thuê GPU trên cloud. README của kohya_ss có hướng dẫn chạy trên Google Colab, Runpod, Novita và Docker. AI Toolkit có hướng dẫn chạy trên Runpod và Modal. Ưu điểm là không cần đầu tư máy. Nhược điểm là phải tải dữ liệu lên và tự quản lý thời gian thuê để tránh phát sinh chi phí ngoài ý muốn. Nếu không muốn tự làm, xem thêm dịch vụ train model LoRA.
5. Chuẩn bị dataset nhân vật: bước quan trọng nhất
Có một câu được nhắc nhiều trong giới train LoRA: dữ liệu tốt quan trọng hơn tham số tốt. Một dataset lộn xộn thì chỉnh tham số đến đâu cũng khó cứu.
5.1. Cần bao nhiêu ảnh?
Không có con số chuẩn trong tài liệu chính thức. Kinh nghiệm phổ biến của cộng đồng:
- 15–30 ảnh chất lượng là khởi đầu tốt cho một nhân vật.
- Có thể làm với khoảng 10 ảnh nếu ảnh rất tốt và đa dạng, nhưng LoRA sẽ kém linh hoạt hơn.
- Trên 50 ảnh không phải lúc nào cũng tốt hơn nếu nhiều ảnh trùng lặp.
5.2. Đa dạng góc, biểu cảm, trang phục
Mục tiêu là để mô hình hiểu điều gì luôn giống nhau (khuôn mặt, màu tóc, màu mắt) và điều gì được phép thay đổi (tư thế, nền, quần áo). Một dataset nhân vật cân đối thường có:
- Góc nhìn: chính diện, nghiêng 3/4 hai bên, nhìn nghiêng, một vài ảnh từ trên xuống hoặc từ dưới lên.
- Khung hình: khoảng 40–50% cận mặt hoặc bán thân để mô hình học kỹ khuôn mặt, phần còn lại là nửa người và toàn thân.
- Biểu cảm: cười, nghiêm túc, ngạc nhiên, nói chuyện. Nếu ảnh nào cũng cười, LoRA sẽ khó tạo nhân vật nghiêm túc.
- Trang phục và bối cảnh: ít nhất 3–4 bộ đồ và nhiều loại nền khác nhau. Nếu 100% ảnh mặc cùng một áo khoác, nhân vật sẽ "dính" áo khoác đó (xem mục 12).
- Ánh sáng: trong nhà, ngoài trời, ánh sáng ấm và lạnh.
5.3. Độ phân giải và cắt ảnh
- Ảnh gốc nên có cạnh ngắn ít nhất bằng độ phân giải train: khoảng 512 px với SD1.5, khoảng 1024 px với SDXL và Flux. Ảnh nhỏ hơn bị phóng lên sẽ làm LoRA học cả độ mờ.
- Bạn không bắt buộc cắt thành hình vuông. kohya sd-scripts hỗ trợ bucketing (gom ảnh theo tỉ lệ khung hình). Tài liệu cấu hình của sd-scripts có các tuỳ chọn
enable_bucket,min_bucket_reso,max_bucket_reso. - Hãy cắt bỏ phần thừa: viền đen, chữ, watermark, người khác trong khung hình.
- Lưu ảnh dạng JPG hoặc PNG. README của AI Toolkit ghi chỉ hỗ trợ jpg, jpeg, png và lưu ý WebP "currently has issues".
5.4. Ảnh nào là ảnh xấu, nên loại?
- Mờ, nhiễu, nén JPEG nặng, chụp màn hình độ phân giải thấp.
- Mặt bị che (tay, kính râm, tóc) hoặc quá nhỏ trong khung.
- Có watermark, logo, chữ, khung viền.
- Ảnh AI tạo ra bị lỗi: thừa ngón tay, mặt méo. LoRA sẽ học luôn cả lỗi.
- Ảnh gần như trùng nhau (cùng góc, cùng biểu cảm, cùng đồ). Nên giữ 1–2 tấm.
- Ảnh có filter hoặc phong cách quá khác các ảnh còn lại, trừ khi bạn muốn LoRA học cả phong cách đó.
6. Caption và trigger word
Mỗi ảnh đi kèm một file văn bản cùng tên (ví dụ image2.jpg và image2.txt) mô tả nội dung ảnh. README của AI Toolkit ghi rõ quy ước này, và kohya cũng mặc định dùng .txt (caption_extension).
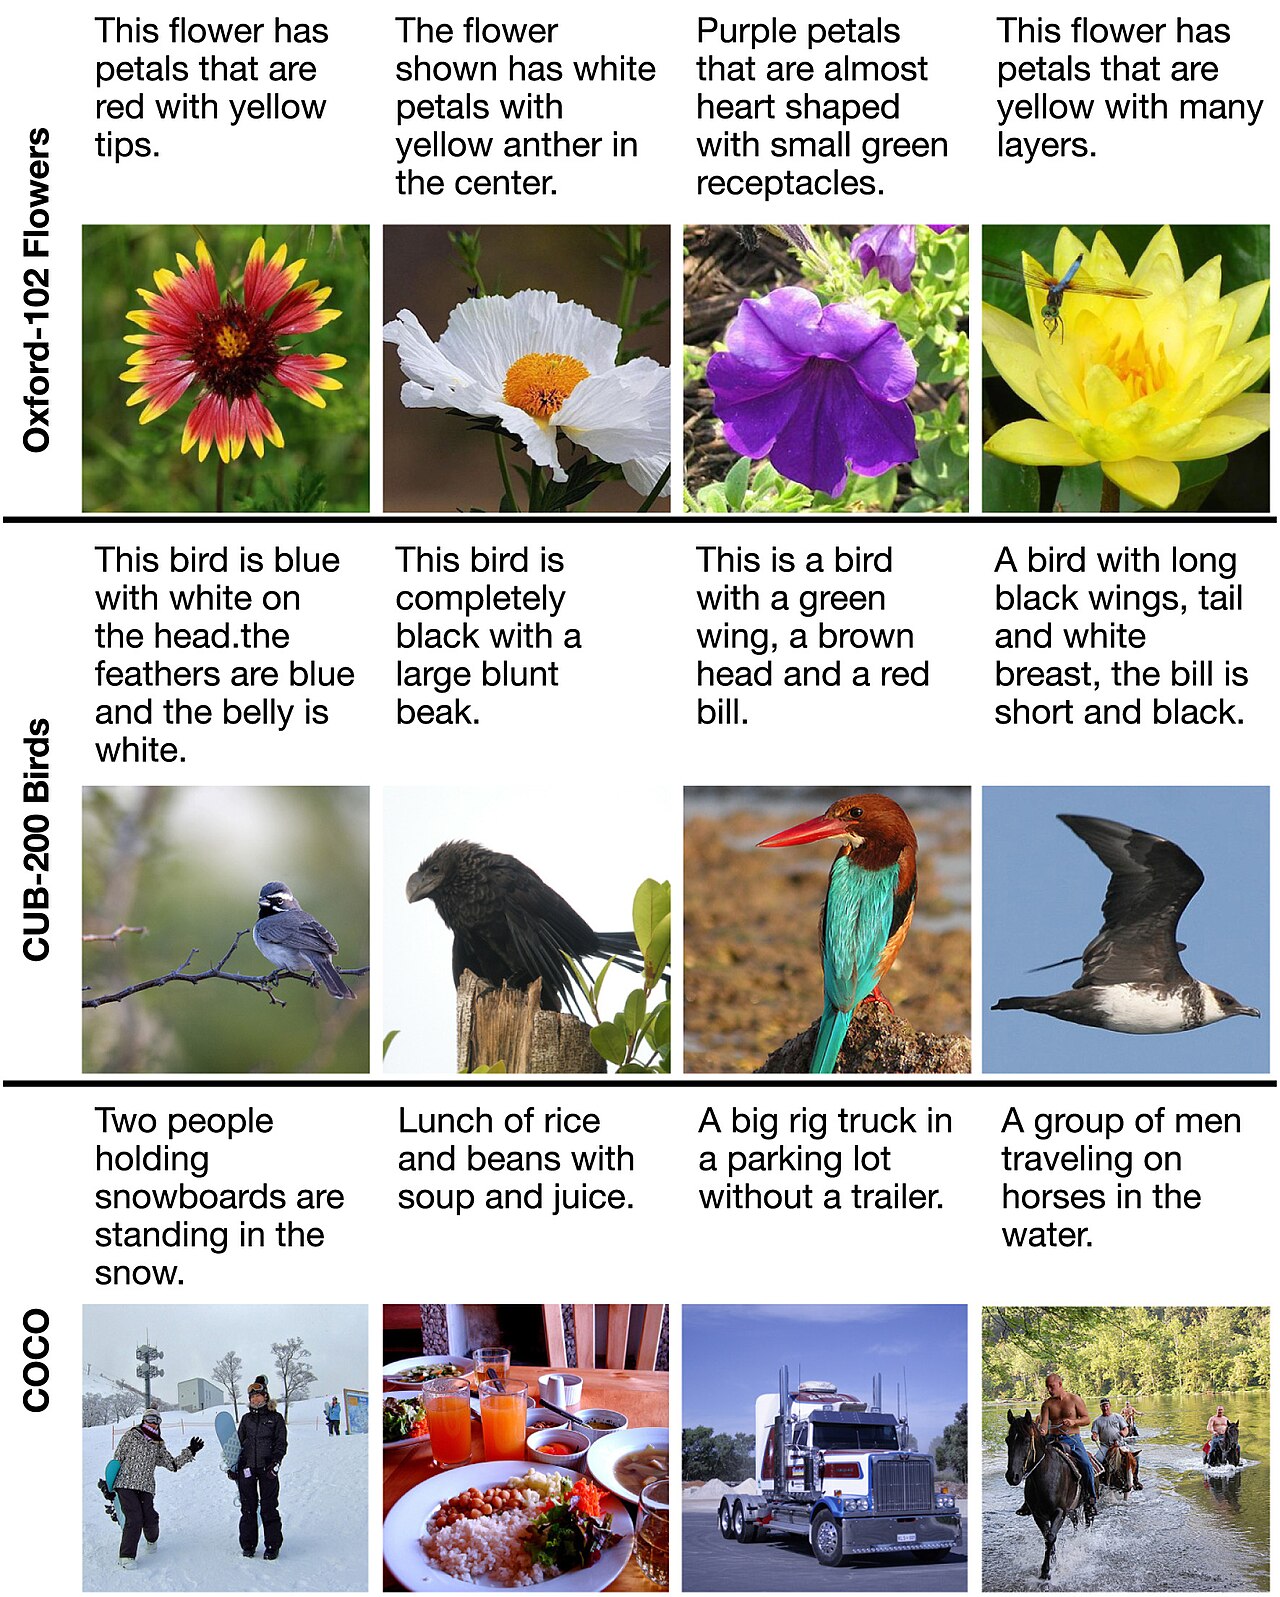 Ví dụ cặp ảnh và caption trong các bộ dữ liệu ảnh–văn bản phổ biến; dataset LoRA cũng theo nguyên tắc "mỗi ảnh một mô tả". Nguồn: Wikimedia Commons, tác giả Stanislav Frolov, Tobias Hinz, Federico Raue, Jörn Hees, Andreas Dengel, giấy phép CC BY 4.0.
6.1. Trigger word
Trigger word là một từ "lạ" mà mô hình chưa biết, ví dụ mylinh_v1 hay skzchar. Từ này được đặt ở đầu mọi caption. Khi tạo ảnh, bạn gõ trigger word để "gọi" nhân vật. Nên tránh dùng từ có nghĩa sẵn như tên người nổi tiếng hay "girl". AI Toolkit cho phép viết [trigger] trong caption và tự thay bằng trigger_word trong file cấu hình.
6.2. Nguyên tắc vàng khi viết caption
Mô tả những gì bạn muốn THAY ĐỔI được, bỏ qua những gì là bản chất của nhân vật.
- Nếu nhân vật luôn có tóc bạc và mắt xanh, đừng ghi "silver hair, blue eyes" ở mọi ảnh. Để trigger word "gánh" các đặc điểm đó.
- Hãy ghi rõ trang phục, tư thế, nền, biểu cảm, góc máy, ví dụ:
mylinh_v1, wearing red hoodie, sitting on a bench, park background, smiling, from side. Nhờ vậy khi tạo ảnh, bạn đổi "red hoodie" thành thứ khác là được.
6.3. Ba cách tạo caption
- WD14 Tagger: sinh tag kiểu Danbooru (
1girl, solo, long hair, ...). Hợp với base model anime trên SDXL hoặc SD1.5. kohya_ss GUI có sẵn công cụ này trong tab Utilities. - BLIP, Florence-2 hoặc các mô hình mô tả ảnh khác: sinh câu văn tự nhiên. Hợp với Flux và các model tả thực vốn hiểu câu dài. Giao diện LoRA Ease của AI Toolkit có nút "Add AI captions with Florence-2" (xem hình ở mục 8).
- Viết tay: chậm nhất nhưng chính xác nhất. Thực tế hay làm là để công cụ tự sinh trước, rồi đọc lại từng file để xoá tag sai và bỏ các tag mô tả đặc điểm cố định của nhân vật.
Mẹo: sd-scripts có keep_tokens (giữ cố định N token đầu khi bật shuffle_caption). Đặt keep_tokens = 1 giúp trigger word luôn đứng đầu.
7. Cấu trúc thư mục (repeats_name)
Với kohya_ss hoặc sd-scripts theo kiểu thư mục DreamBooth truyền thống, tên thư mục con có dạng <số lần lặp>_<tên>. Bộ test trong chính repo kohya_ss dùng thư mục tên 10_darius kawasaki person, nghĩa là mỗi ảnh được lặp 10 lần trong mỗi epoch, kèm từ khoá "darius kawasaki" và class "person". Ví dụ:
lora_mylinh/
├── img/
│   └── 10_mylinh_v1 woman/
│       ├── 001.jpg
│       ├── 001.txt
│       ├── 002.png
│       └── 002.txt
├── model/      (nơi lưu file LoRA)
└── log/        (log để xem bằng TensorBoard)
Nếu dùng file cấu hình .toml của sd-scripts, số lần lặp được khai báo bằng num_repeats thay vì đặt trong tên thư mục. Tài liệu ghi tham số này tương đương --dataset_repeats.
Số bước train được tính thế nào? Số bước mỗi epoch ≈ (số ảnh × repeats) ÷ batch size. Ví dụ 20 ảnh × 10 repeats ÷ batch 2 = 100 bước/epoch. Train 10 epoch thì được khoảng 1.000 bước.
8. Cài đặt và sử dụng công cụ train
Có hai công cụ mã nguồn mở phổ biến, đều có giấy phép dễ dùng:
- kohya_ss (bmaltais/kohya_ss, Apache-2.0): giao diện web (Gradio) cho bộ script kohya-ss/sd-scripts (Apache-2.0). Hỗ trợ SD1.5, SDXL và các dòng mới.
- AI Toolkit (ostris/ai-toolkit, MIT): mạnh với Flux và các model đời mới, chạy bằng file cấu hình YAML hoặc giao diện web.
8.1. kohya_ss từng bước
- Cài Python và git, cùng driver NVIDIA mới.
- Clone repo:
git clone https://github.com/bmaltais/kohya_ss.git. - Cài theo hướng dẫn chính thức cho hệ điều hành của bạn. README có 4 cách:
uvhoặcpipcho Windows và Linux (macOS dùngpip). Tài liệu nóiuvnhanh hơn và cô lập thư viện gọn hơn. - Chạy giao diện:
gui.battrên Windows hoặc./gui.shtrên Linux. Nếu chạy trên máy chủ, có thể dùng--listen 0.0.0.0 --server_port 7860 --headless. - Mở trình duyệt vào địa chỉ terminal hiển thị, chọn tab LoRA, điền đường dẫn base model, thư mục ảnh và thư mục output, chỉnh tham số (mục 9) rồi bấm Start training.
Nếu thích dòng lệnh, bản gốc sd-scripts chạy kiểu sau (rút gọn từ tài liệu train_network.md):
accelerate launch --num_cpu_threads_per_process 1 train_network.py \
  --pretrained_model_name_or_path="<duong_dan_model>" \
  --dataset_config="my_dataset_config.toml" \
  --output_dir="<thu_muc_output>" --output_name="my_lora" \
  --save_model_as=safetensors --network_module=networks.lora \
  --network_dim=16 --network_alpha=1 --learning_rate=1e-4 \
  --optimizer_type="AdamW8bit" --lr_scheduler="constant" --sdpa \
  --max_train_epochs=10 --save_every_n_epochs=1 \
  --mixed_precision="fp16" --gradient_checkpointing
Lưu ý: script này dành cho SD1.x/2.x. sd-scripts có các script riêng cho SDXL và các dòng khác, ví dụ sdxl_train_network.py.
8.2. AI Toolkit từng bước
- Yêu cầu theo README: Python ≥ 3.10 (khuyên dùng 3.12), GPU NVIDIA, venv, git.
- Cài:
git clone https://github.com/ostris/ai-toolkit.git, tạo venv, rồipip install -r requirements.txt(cài PyTorch theo hướng dẫn trong README). - Chép file mẫu
config/examples/train_lora_flux_24gb.yamlvào thư mụcconfig, đổi tên, sửa theo chú thích (đường dẫn dataset,trigger_word, số bước...). - Chạy:
python run.py config/ten_file.yml. - Hoặc dùng giao diện web của AI Toolkit. Nếu mở giao diện ra mạng, README khuyên đặt biến
AI_TOOLKIT_AUTHlàm mật khẩu bảo vệ.
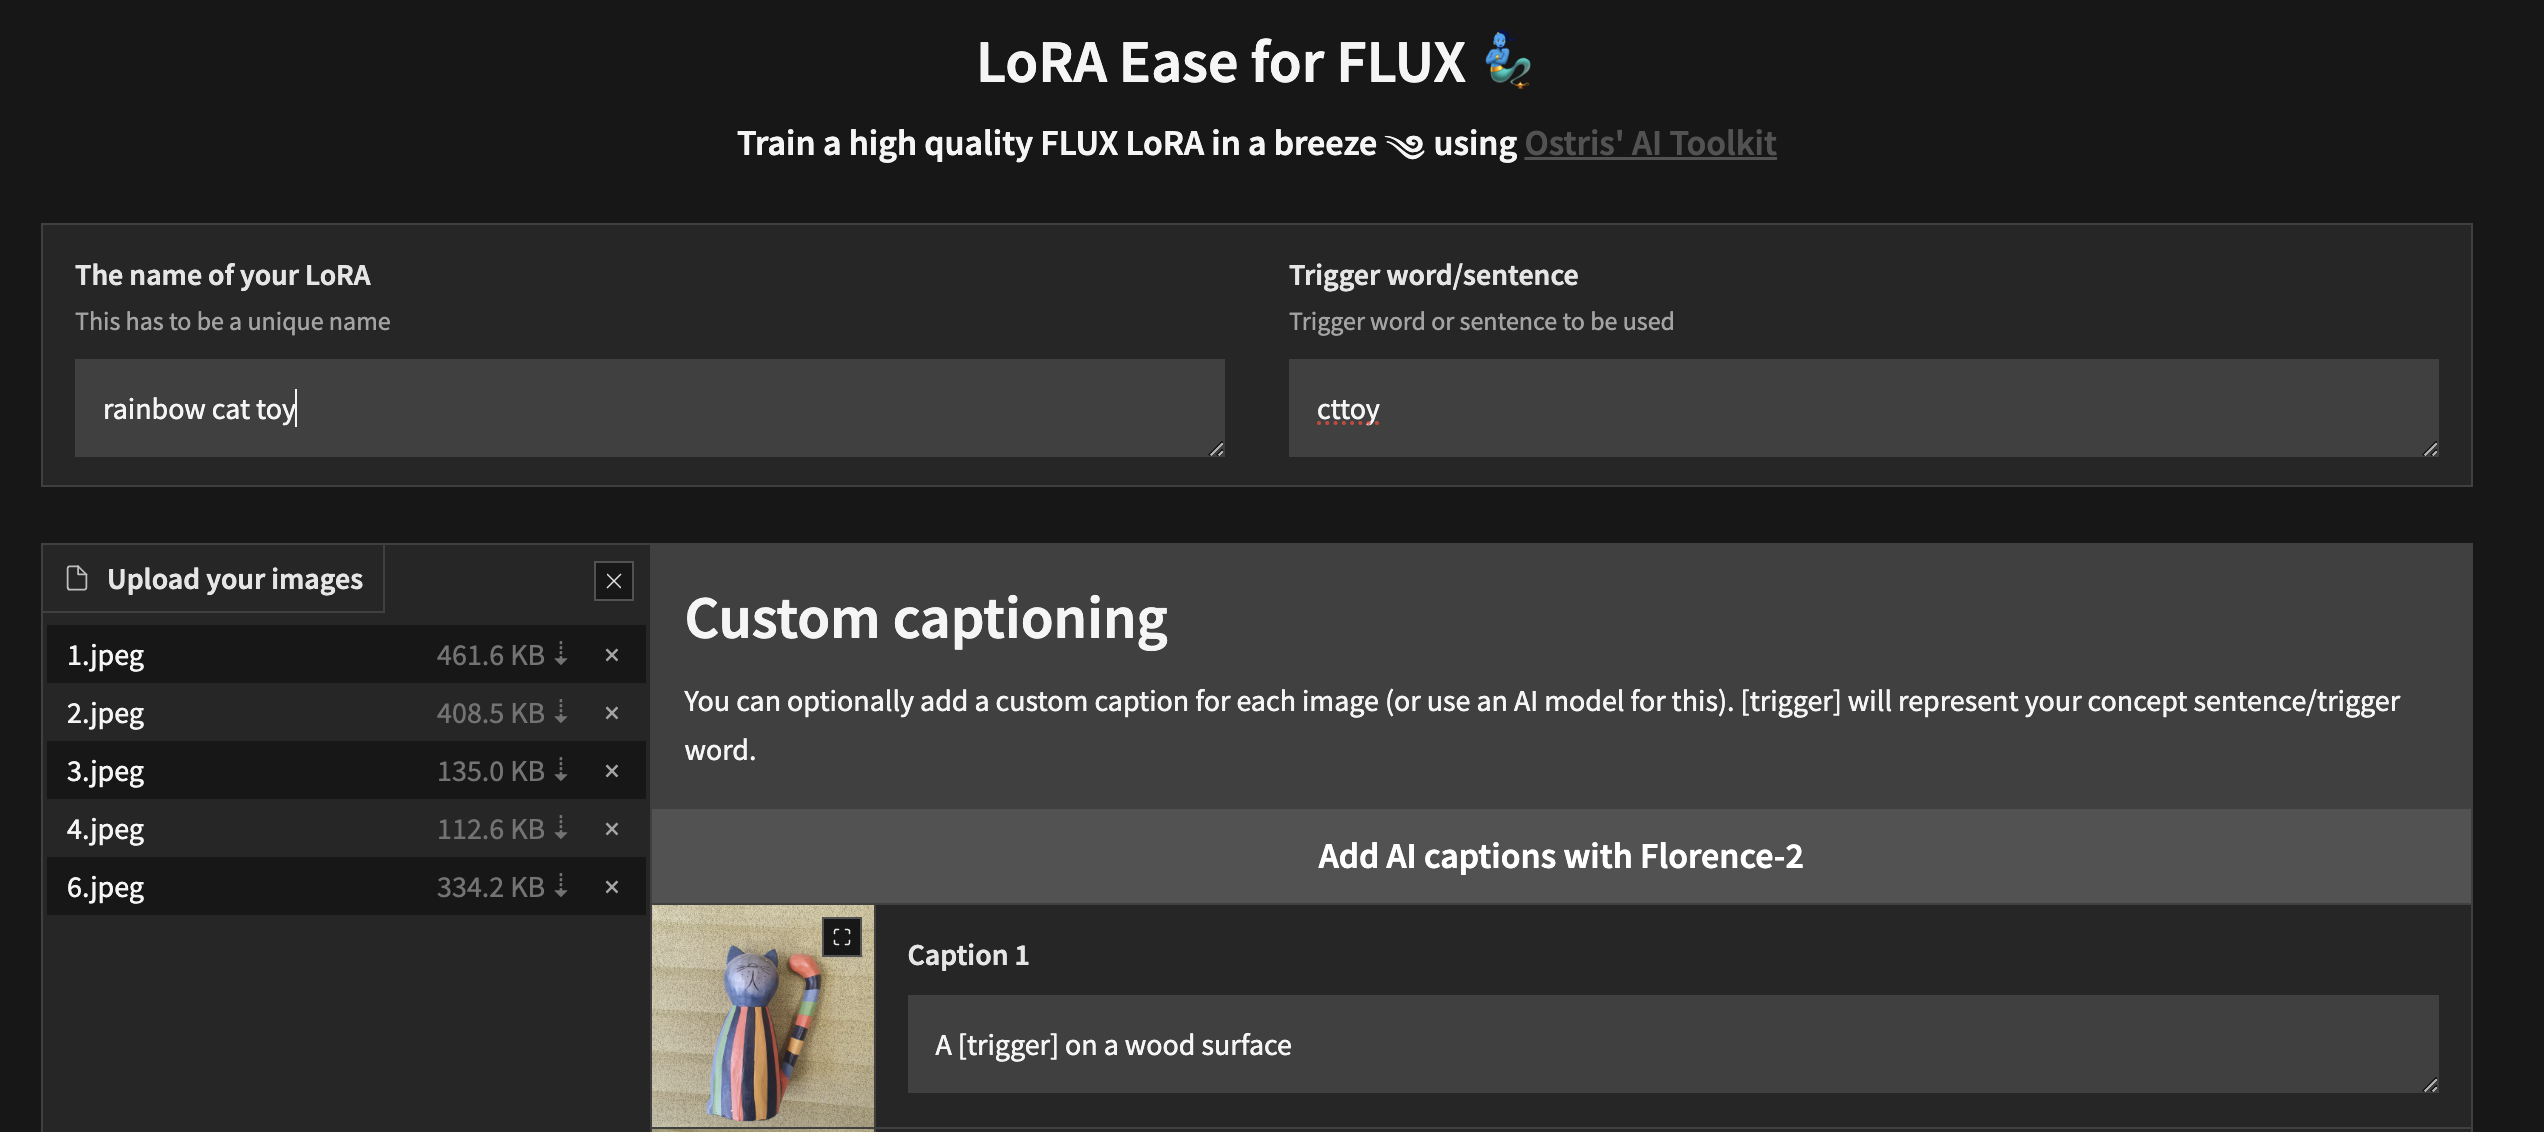 Giao diện LoRA Ease (dựa trên AI Toolkit): đặt tên LoRA, trigger word, tải ảnh và viết caption, có nút tự sinh caption bằng Florence-2. Nguồn: ostris/ai-toolkit – assets/lora_ease_ui.png, giấy phép MIT.
9. Bảng tham số dễ hiểu
Giá trị gợi ý dưới đây là điểm khởi đầu phổ biến cho LoRA nhân vật. Những chỗ có trích tài liệu kohya sd-scripts được ghi rõ.
| Tham số | Ý nghĩa dễ hiểu | Gợi ý khởi đầu |
|---|---|---|
Rank (network_dim) |
"Dung lượng trí nhớ" của LoRA. Cao hơn thì nhớ nhiều chi tiết hơn, nhưng file nặng hơn và dễ học vẹt | 16–32 cho nhân vật. Ví dụ trong tài liệu kohya dùng 16 |
Alpha (network_alpha) |
Hệ số co giãn, ảnh hưởng mức "mạnh" của việc học. Alpha thấp so với rank tương đương với giảm learning rate | Tài liệu kohya: thường khoảng một nửa network_dim, cũng có thể bằng nó |
| Learning rate (LR) | Tốc độ học mỗi bước. Cao quá thì "cháy" ảnh, thấp quá thì học không vào | Ví dụ kohya: 1e-4. Text encoder nên thấp hơn U-Net (theo tài liệu) |
| Epochs | Số lần đi hết toàn bộ dataset (đã tính repeats) | 10–20, lưu mỗi epoch để chọn sau |
| Steps | Tổng số bước = epochs × (ảnh × repeats ÷ batch). Nếu đặt max_train_epochs thì nó được ưu tiên hơn max_train_steps |
Nhân vật thường rơi vào khoảng 1.000–3.000 bước (tham khảo cộng đồng) |
| Batch size | Số ảnh xử lý cùng lúc. Lớn hơn thì nhanh hơn nhưng tốn VRAM hơn | 1–2 nếu VRAM hạn chế |
| Optimizer | Thuật toán cập nhật trọng số. Tài liệu kohya liệt kê AdamW8bit, AdamW, Lion, DAdaptation, Adafactor | AdamW8bit (tiết kiệm VRAM, cần bitsandbytes). Prodigy hoặc DAdaptation tự chỉnh LR, khi dùng thường đặt LR = 1 |
| Resolution | Kích thước ảnh khi train | 512 (SD1.5), 1024 (SDXL, Flux) |
| Mixed precision | Tính toán với số 16-bit để nhanh và nhẹ hơn | fp16, hoặc bf16 nếu card hỗ trợ (RTX 30xx trở lên) |
| Save every N epochs | Lưu một file LoRA sau mỗi N epoch | 1, để so sánh và chọn epoch tốt nhất |
Hai tuỳ chọn tiết kiệm VRAM nên bật: --gradient_checkpointing và cache latent. Cả hai đều có trong lệnh ví dụ hoặc tài liệu của sd-scripts.
10. Theo dõi quá trình train và ảnh mẫu
Đừng đợi train xong mới xem kết quả. Có hai cách theo dõi:
- Ảnh mẫu (sample): sd-scripts hỗ trợ
--sample_prompts(file prompt) và--sample_every_n_stepshoặc--sample_every_n_epochs. Cứ sau mỗi chặng, công cụ tự tạo vài ảnh thử với LoRA đang train. AI Toolkit cũng có phầnsampletrong file cấu hình. Hãy viết 3–4 prompt mẫu đa dạng: cận mặt, toàn thân, trang phục khác hẳn dataset, phong cách khác. - Loss (TensorBoard): loss là chỉ số sai số, nhưng với mô hình khuếch tán (diffusion) nó dao động nhiều và không phản ánh chính xác chất lượng. Hãy dùng nó để phát hiện bất thường (loss bằng NaN, tăng vọt), còn đánh giá chính vẫn bằng mắt.
Dấu hiệu nên dừng sớm: ảnh mẫu đã giống nhân vật nhưng bắt đầu cứng, màu bị gắt, nền và trang phục luôn giống dataset. Đó là lúc mô hình bắt đầu học vẹt.
11. Thử LoRA trong ComfyUI và chọn epoch tốt nhất
Khi train xong, bạn có nhiều file như my_lora-000004.safetensors, my_lora-000008.safetensors... Mỗi file là trạng thái sau một số epoch. Cách thử:
- Chép các file vào thư mục
models/lorascủa ComfyUI. Nếu chưa quen ComfyUI, xem ComfyUI là gì – hướng dẫn cho người mới. - Thêm node Load LoRA giữa node Load Checkpoint và phần còn lại của workflow. Chọn file LoRA, chỉnh
strength_modelvàstrength_clip(bắt đầu ở 0.8–1.0). - Cố định seed và dùng cùng một bộ prompt, rồi đổi lần lượt từng file epoch và các mức strength. Như vậy chỉ còn một biến thay đổi và bạn so sánh được công bằng.
- Xếp kết quả thành lưới (XY plot) như ví dụ dưới để dễ nhìn.
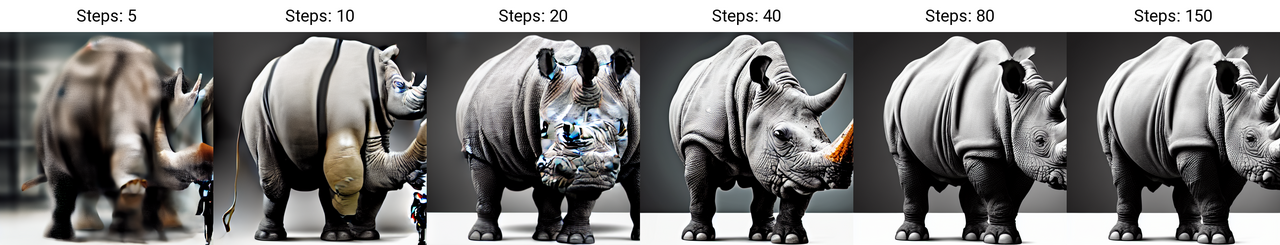 Ví dụ lưới XY plot: cùng prompt và seed, chỉ đổi một thông số (ở đây là số bước lấy mẫu). Khi chọn LoRA, bạn đổi epoch hoặc strength theo cách tương tự. Nguồn: Wikimedia Commons, ảnh tạo bằng Stable Diffusion WebUI, Public domain.
Chọn epoch thế nào? Một LoRA tốt cần đạt cả 4 tiêu chí: (1) nhận ra ngay nhân vật, (2) đổi được trang phục và bối cảnh theo prompt, (3) chạy được ở strength 0.7–0.9 mà không vỡ, (4) phối được với LoRA phong cách khác. Thường epoch tốt nhất nằm ở khoảng giữa đến 2/3 quá trình train, không phải epoch cuối cùng.
12. Lỗi thường gặp và cách sửa
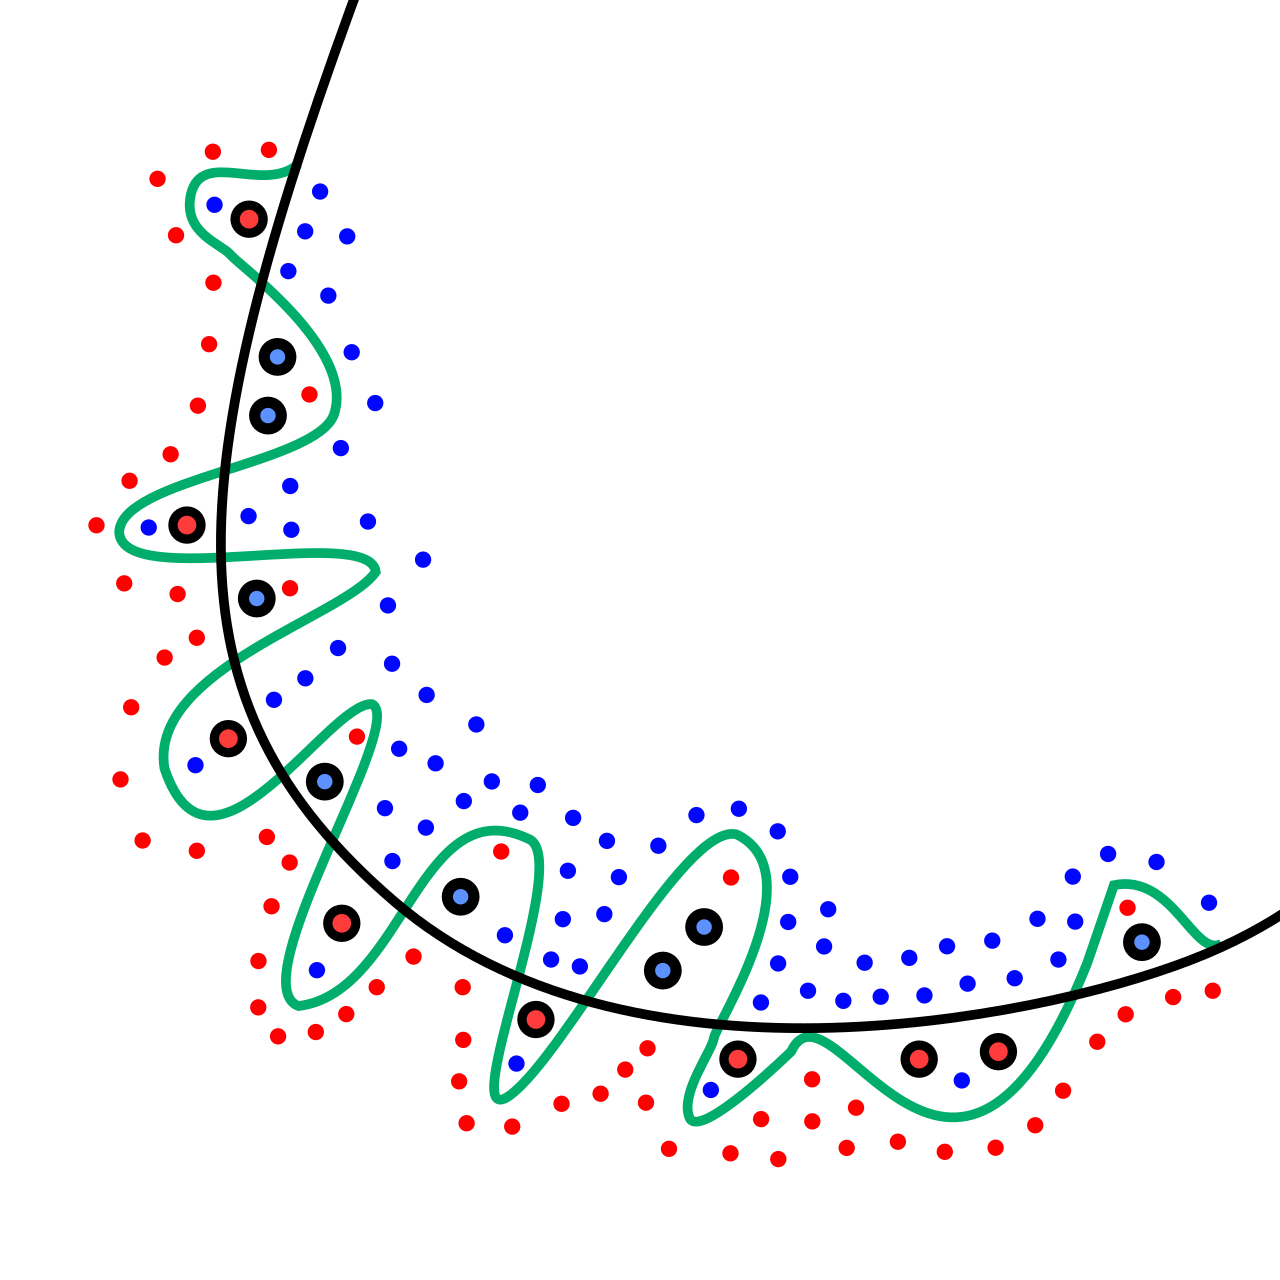 Minh hoạ overfitting (học vẹt): đường xanh lá bám sát từng điểm dữ liệu train, đường đen tổng quát hơn. LoRA bị overfit cũng "thuộc lòng" ảnh train thay vì hiểu nhân vật. Nguồn: Wikimedia Commons – Overfitting.svg, tác giả Chabacano, giấy phép CC BY-SA 4.0.
| Triệu chứng | Nguyên nhân có thể | Cách sửa |
|---|---|---|
| Overfit: ảnh cứng, màu gắt, luôn ra tư thế, nền giống dataset, prompt khác bị lờ đi | Train quá nhiều bước, LR quá cao, rank quá lớn, dataset ít đa dạng | Chọn epoch sớm hơn, giảm LR hoặc số repeats, hạ strength xuống 0.6–0.8, bổ sung ảnh đa dạng |
| Underfit: không giống nhân vật, trigger word không tác dụng | Quá ít bước, LR quá thấp, caption mô tả quá kỹ đặc điểm cố định | Train thêm epoch, tăng LR một chút, bỏ các tag mô tả đặc điểm cố định khỏi caption |
| Mất mặt / mặt không ổn định | Quá ít ảnh cận mặt, mặt quá nhỏ trong ảnh toàn thân, ảnh mờ | Thêm ảnh cận mặt rõ nét (khoảng 40–50% dataset), loại ảnh mờ. Khi tạo ảnh toàn thân có thể dùng thêm bước sửa mặt (FaceDetailer) |
| Trang phục dính vào nhân vật | Đa số ảnh cùng một bộ đồ, caption không nhắc đến bộ đồ | Thêm ảnh với trang phục khác; ghi rõ tên trang phục trong caption để mô hình hiểu đó là thứ "tách rời được" |
| Phong cách bị kéo theo (LoRA làm mọi ảnh giống tranh gốc) | Dataset cùng một phong cách vẽ hoặc filter | Đa dạng nguồn ảnh, hoặc mô tả phong cách trong caption |
| Hết VRAM (CUDA out of memory) | Batch, resolution hoặc rank quá lớn | Giảm batch xuống 1, bật gradient checkpointing, dùng AdamW8bit, cache latent; với Flux dùng lượng tử hoá |
| Loss bằng NaN, ảnh đen | LR quá cao, lỗi precision | Giảm LR, thử đổi fp16 sang bf16 |
13. Bản quyền và đạo đức khi train khuôn mặt người thật
Đây là phần quan trọng không kém phần kỹ thuật:
- Chỉ train khuôn mặt người thật khi có sự đồng ý rõ ràng của người đó, tốt nhất là bằng văn bản và ghi rõ mục đích sử dụng. Hình ảnh cá nhân là dữ liệu cá nhân. Ở Việt Nam, Bộ luật Dân sự có quy định về quyền đối với hình ảnh của cá nhân, và có các quy định về bảo vệ dữ liệu cá nhân. Hãy hỏi ý kiến luật sư cho trường hợp cụ thể. Bài này không phải tư vấn pháp lý.
- Không tạo nội dung giả mạo, khiêu dâm, bôi nhọ hoặc lừa đảo bằng khuôn mặt người khác (deepfake). Nhiều nền tảng và nhiều quốc gia đã cấm hoặc xử phạt hành vi này.
- Ảnh dùng để train cũng có bản quyền. Ảnh lấy từ mạng, tranh của hoạ sĩ khác hay nhân vật thương mại có thể vướng bản quyền, nhất là khi bạn dùng vào mục đích thương mại.
- Kiểm tra giấy phép base model. Một số model có giấy phép hạn chế mục đích thương mại hoặc có điều khoản sử dụng có trách nhiệm.
- Minh bạch: khi đăng nội dung do AI tạo, nhất là nhân vật trông giống người thật, hãy ghi rõ đó là ảnh AI.
14. Câu hỏi thường gặp (FAQ)
Train một LoRA nhân vật mất bao lâu? Tuỳ GPU, base model và số bước. Với SD1.5 hoặc SDXL trên GPU tầm trung, thường mất từ vài chục phút đến vài giờ. Flux lâu hơn. Đây là ước lượng chung, không phải số đo cụ thể.
Có train được trên laptop không? Được, nếu laptop có GPU NVIDIA đủ VRAM (xem mục 4). Nếu không, dùng Colab hoặc thuê GPU cloud.
LoRA SDXL dùng cho model SDXL khác được không? Thường được với các checkpoint cùng dòng, nhưng kết quả tốt nhất khi dùng gần với base đã train. LoRA SDXL không dùng được cho SD1.5 hay Flux.
Nên dùng rank bao nhiêu? Với nhân vật, 16–32 là mức hay dùng. Rank cao hơn không tự động tốt hơn.
Có cần ảnh regularization (ảnh class) không? Không bắt buộc. Ảnh regularization giúp giữ khả năng tạo "người chung chung" của model, nhưng làm tăng thời gian train. Nhiều người train nhân vật không dùng.
Dùng nhiều LoRA cùng lúc được không? Được, nhưng nên hạ strength từng LoRA để chúng không "đánh nhau".
Tôi không muốn tự làm thì sao? Bạn có thể tham khảo dịch vụ train model LoRA của Sydigi.
Bài liên quan
- LoRA và Checkpoint khác nhau thế nào
- Cách viết prompt tạo ảnh AI hiệu quả
- ComfyUI là gì – hướng dẫn cho người mới
- Dịch vụ train model LoRA
Nguồn tham khảo
- Hu et al., LoRA: Low-Rank Adaptation of Large Language Models, arXiv 2021.
- kohya-ss/sd-scripts – docs/train_network.md và config_README-en.md (Apache-2.0).
- bmaltais/kohya_ss – README (Apache-2.0).
- ostris/ai-toolkit – README (MIT).
- Hugging Face Diffusers – tài liệu LoRA.
- microsoft/LoRA (MIT).
- Hình ảnh: Wikimedia Commons (CC BY-SA 4.0, CC BY 4.0, Public domain) và ostris/ai-toolkit (MIT), ghi nguồn dưới từng hình.

Train model AI tạo ảnh, dựng hạ tầng API và biến ý tưởng AI thành phần mềm chạy thật.
Xem giới thiệu →